Активно репортите все нерелейтед посты кнопкой на сообщениях. Этот тред только про ИИ новости, не позволим троллям загаживать тред шитпостом и бесконечным словоблудием.
🤖 Робототехника
Reward AI представила новую демонстрацию OM-1, в которой показаны доставка на последнем этапе маршрута, обращение с посылками на лестницах и выполнение домашних дел.
AgiBot представила гуманоидного робота AHA3, модель GO-3 и бенчмарк Worken.
Waymo и Toyota планируют испытания автономного bZ4X в Японии в 2027 году.
Похоже, пора наконец начать ходить в спортзал: ИИ-роботы уже это делают. В центре деятельности стартапов в области робототехники находится их секретный объект «робозал» в Мюнхене, где до ста человекоподобных роботов из компаний со всего мира постоянно тренируются и выполняют различные задачи.
Tesla, по сообщениям, планирует открыть бронирование роботов Optimus в начале декабря
Meta, по сообщениям, создала гуманоидного робота «Max» совместно с Fourier; работа над второй версией уже ведётся
HALO обучает гуманоидных роботов координировать действия с людьми-партнёрами во время совместных задач по переноске грузов
🧠 Модели
Alibaba анонсирует линейку Qwen4 на конференции Apsara в Амстердаме; её выход ожидается на следующей неделе.
Google представила Gemini 4 Carbon, обеспечивающую «значительный скачок» в области кибербезопасности.
Mistral выпустила веса своей ИИ-модели с триллионом параметров, ориентированной на кибербезопасность.
NVIDIA выпустила модель распознавания речи Nemotron 3.5 Transcribe с открытыми весами, поддерживающую 40 языков.
Nanbeige выпустила модель с открытыми весами Nanbeige4.3-33B, демонстрирующую агентную производительность на уровне современных передовых разработок.
Mistral AI официально выпустила модель Large 4 (Le Chonk). Ранее в этом месяце Mistral представила Large 4 в общедоступной предварительной версии, а теперь выпускает для всех улучшенную версию, которая, по утверждению компании, является «лучшей моделью с открытыми весами для программирования».
Google представила свою самую реалистичную на сегодняшний день модель мира.
GPT-6 Rosalind от OpenAI открывает новые возможности в биологии для авторизованных лабораторий
Пять моделей Qwen3.8-27B сравнялись с Fable 5 по результатам теста LiveCodeBench Hard
Gemini 4 Carbon от Google возглавляет рейтинги
🔓 Открытый исходный код
Speridlabs выпустила Idol — открытую модель преобразования изображений в трёхмерные объекты. По заявлению Speridlabs, Idol работает на потребительских графических процессорах и использует менее 7,2 ГБ видеопамяти.
Cisco открывает исходный код Quarry — инструмента для обнаружения атак на ИИ-агентов, скрытых в безобидных действиях.
Независимые специалисты по вычислительным исследованиям представили ChemEZ — фреймворк с открытым исходным кодом, который связывает большие языковые модели с инструментами молекулярного моделирования для решения сложных задач в области химии.
🛠 Инструменты для разработчиков
Anthropic увеличила лимит размера запросов к Claude API до 128 МБ.
ИИ Claude от Anthropic блокирует клонирование видеоигр и обратную разработку — масштабные новые ограничения также затрагивают добросовестных разработчиков и базовые задачи по устранению неполадок
🧰 Инструменты
Anthropic только что запустила инструменты, которые позволяют компаниям увидеть, на что расходуются их деньги, выделенные на ИИ.
📦 Продукты
Starbucks хочет использовать ИИ, чтобы показывать вам «персонализированное цифровое меню» в окне обслуживания автомобилистов.
Anthropic переименовывает тарифные планы Claude Max. Тариф Max 5x теперь называется просто Max, а тариф Max 20x — Ultra. Также выполняется поэтапная отмене пятичасового ограничения для подтверждённых аккаунтов Ultra.
📱 Приложения
Призрак в машине: ИИ преследует поиски сверхъестественного. Исследуя места, которые считаются населёнными привидениями, охотники за привидениями используют собственное программное обеспечение, например приложение, которое сопоставляет сигналы с датчиков телефона с различными словами в базе данных. В эпоху ChatGPT охотники за привидениями исследуют уже мир ИИ.
Meta незаметно запустила приложение для моды на базе ИИ под названием Style Sketch.
Теперь можно создавать и редактировать файлы Google Docs прямо в чатах Gemini.
Amazon обновляет Alexa, чтобы помочь пользователям управлять списками покупок и подписками, а также изменять инструкции по доставке.
Экстрасенсы выступают против предсказаний, созданных ИИ. Практикующие специалисты предупреждают, что компьютерные предсказания лишены эмпатии и эмоциональной связи, которые являются основой гадания. Приложение Your AI Psychic стало одним из многочисленных участников всё более переполненного рынка мобильных приложений и сайтов, обещающих пользователям духовные прозрения и знания об их будущем, созданные алгоритмами.
Улучшенная функция автозаполнения Chrome теперь может извлекать информацию из Gmail, чтобы помогать заполнять формы.
В Gemini Live на Android может появиться «автономный режим». Android Authority обнаружило в бета-версии приложения Google для Android (v17.71.17) код, указывающий на появление нового режима со слоганом: «Используйте Gemini Live без подключения к интернету».
Spotify может запустить инструмент для ремикширования музыки с помощью ИИ в следующем году. По сообщениям, платформа для потокового прослушивания музыки планирует выпустить эту функцию в первом квартале 2027 года. Она позволит пользователям создавать с помощью запросов ремиксы и кавер-версии участвующих в программе песен, сгенерированные ИИ.
Число пользователей Muse AI от Meta достигло 10 миллионов.
Карпати за два часа создал конкурента YouTube с 6 454 видео с помощью Claude Opus 5.5
💻 Оборудование
Gemini появится в очках AURA. Первые проводные XR-очки на базе Android XR предоставят доступ к приложениям, фильмам и помощи Gemini, где бы вы ни находились.
Производители чипов памяти впервые заработали больше, чем пять крупнейших технологических компаний США
🖱 Аппаратное обеспечение
Рабочая игровая консоль NES теперь функционирует внутри весов модели Qwen3.5.
Сэм Альтман утверждает, что оперативную память лучше централизовать в центрах обработки данных, а не размещать в персональных компьютерах.
⚙ Инфраструктура
Университет Пердью стал первым академическим учреждением США, развернувшим специализированную суперкомпьютерную инфраструктуру на базе TPU для поддержки исследований в области физического ИИ и автономной робототехники.
Строительство кампуса ИИ Monarch компании Nscale в Западной Виргинии столкнулось с проблемами и противодействием.
Можно ли производить центры обработки данных для ИИ массово, как автомобили? Этот стартап намерен это выяснить. Компания Runware, работающая в сфере инфраструктуры ИИ, вновь привлекает внимание. Она хочет построить завод, на котором модули для ИИ будут собираться на производственной линии, как автомобили.
Протест против центров обработки данных в штате Мэн определит, кто будет контролировать Сенат. Пока технологические миллиардеры направляют рекордные суммы денег на напряжённую сенатскую гонку в штате Мэн, сельские избиратели выступают против нагрузки на ресурсы, роста коммунальных расходов и призрачных рабочих мест, обещанных в рамках бума центров обработки данных для ИИ.
Жители США утверждают, что связанная с Маском компания xAI предложила выкупить их дома при условии, что они не будут подавать иски из-за шума от центра обработки данных.
Избиратели в Техасе согласны: они ненавидят центры обработки данных ИИ.
Как показало исследование, моратории и запреты на строительство центров обработки данных могут замедлить развитие ИИ лишь на несколько дней или даже часов.
По данным Bank of America, расходы на центры обработки данных для ИИ к 2028 году более чем удвоятся и достигнут 2,1 трлн долларов.
Сэм Альтман хочет, чтобы центры обработки данных могли самовоспроизводиться.
Альтман встречается с 50 руководителями Samsung, чтобы обеспечить поставки памяти для Stargate
В буме расходов на ИИ появляются трещины. Инвесторы всё больше обеспокоены огромными расходами крупных технологических компаний на инфраструктуру ИИ: свободный денежный поток Big Tech становится отрицательным, а долговая нагрузка растёт.
Энергетические потребности масштабного развертывания инфраструктуры ИИ просто невероятны. К 2030 году на долю центров обработки данных может приходиться 15–20% всего электроснабжения США. Уже к 2029 году Соединенным Штатам может не хватать электроэнергии в объеме, эквивалентном потреблению 18 таких городов, как Нью-Йорк.
Расследование деятельности европейских центров обработки данных для ИИ выявило случаи поражения электрическим током и кражи заработной платы
🛰 ИИ в космосе
Спутник Google с ИИ-сервером передал на Землю свой первый ответ. Первый спутник Google, выполняющий функции центра обработки данных, вышел в онлайн и пишет стихи.
🧪 Исследования
Институт Reuters при Оксфордском университете опубликовал доклад «Генеративный ИИ и новости — 2026», в котором говорится, что мировые редакции перешли от экспериментального тестирования генеративного ИИ к его использованию в качестве ключевой операционной инфраструктуры.
В новой исследовательской препринт-публикации с ИИ предлагаются четыре способа помочь исследовательским агентам работать с людьми. Соавтор Джейсон Уэстон описывает бенчмарки с участием людей, обнаружение взломов, обучение на симулированных пользователях и критерии оценки текстов, согласованные с экспертными стандартами.
По сообщениям, DeepSeek V4.1F использовала 1,2 миллиарда токенов, пытаясь провести обратную разработку бинарного файла возрастом 20 лет.
Математики опубликовали доклад о будущем математических исследований в эпоху ИИ.
Утверждение MIT о том, что 95% пилотных проектов с ИИ терпят неудачу, основывалось на неправильной интерпретации воронки и 153 ответах на опрос.
Согласно новому исследованию Стокгольмского университета, снижение тревожности при получении обратной связи от ИИ почти такое же, как при получении обратной связи от психотерапевта-человека.
Согласно опросу в США, 32,3% молодых людей использовали ИИ, чтобы задавать вопросы об алкоголе и наркотиках. Уровень их доверия к таким ответам заметно высок.
ИИ проводит операцию на мозге мыши, утверждает обладатель докторской степени Оксфордского университета.
Исследование Anthropic: ИИ-агенты влияют на экспертные суждения в 86% случаев. Эксперты перенимают случайные мнения ИИ-агента и считают их собственными — к такому выводу пришли исследователи Anthropic
OpenAI и Anthropic в один и тот же день опровергли гипотезу об экспоненциальном времени, OpenAI добавила доказательство для теории Янга — Миллса, а агенты Axiom формализовали «Огромную теорему», выявив 34 отклонения.
Агенты GPT-Rosalind проанализировали атлас CRISPR мозга за 32 минуты.
Химики разработали инструмент на основе ИИ, позволяющий превращать человеческую изобретательность в ферменты, улучшающие качество жизни.
⚠ Безопасность ИИ
Поддельное расширение Claude Code устанавливает SSH-бэкдор на 5 тысячах компьютеров разработчиков.
Vapor Panda провела атаки с использованием DeepSeek против более чем 200 целей. Связанная с Китаем группировка VAPOR PANDA использовала платформу для ИИ-агентов под названием ARTEX, работающую преимущественно на базе большой языковой модели DeepSeek и ещё одной коммерческой модели, чтобы проводить вторжения в более чем 200 организаций как минимум в 14 странах за 11-дневный период, начавшийся 17 октября.
Четырёхуровневая система мониторинга OpenAI обнаружила утечку через DNS за 15 минут.
Созданная ИИ цепочка эксплойтов получила права суперпользователя на 25 серверах PAN-OS, включая серверы правительства США.
ИИ-агент Cipher обнаружил четыре уязвимости в программном обеспечении ускорителя частиц менее чем за четыре часа.
США расследовали китайский шпионский заговор, целью которого был генеральный директор Nvidia.
По сообщениям, Astra отказалась анализировать код для снятия цифровых отпечатков браузера, в котором использовались названия функций, отсылающие к рицину. В публикации со ссылкой на исследователя безопасности veritas описывается JavaScript-код для снятия цифровых отпечатков браузера с домена, связанного с ServicePipe, в котором названия функций содержали упоминания рицина и смертельных доз. В публикации говорится, что Astra отказалась анализировать скрипт, в том числе с помощью Daybreak Blue, тогда как GLM-5.3 смогла его проанализировать. Названия в скрипте были созданы специально, чтобы блокировать ИИ.
Утечка данных из Northflank привела к злоупотреблению ИИ API-ключами клиентов.
Вредоносная программа для кражи информации Volta-Autodoxer использует ИИ для доксинга жертв. Исследователи Cisco Talos выявили программу VOLTA для кражи информации и задокументировали новую кампанию распространения вредоносного ПО, в рамках которой используются модели машинного обучения для автоматической оценки и приоритизации украденных корпоративных данных.
Wiz сообщает, что в октябре были взломаны как минимум девять платформ для разработчиков ИИ.
Преступник потратил более 7 тысяч долларов на ИИ-сервисы для атак с целью вымогательства, а затем оставил улики на всеобщее обозрение.
Поддельный репозиторий GitHub обманывает ИИ-агентов для программирования, заставляя их устанавливать вредоносную программу SolanaCry.
Уязвимости EMBRACE в пяти инструментах для программирования с ИИ позволяют выполнять код и похищать файлы.
Созданный Claude эксплойт использует уязвимость Linux Kernel TCP с оценкой 9,8 по шкале CVSS, затрагивающую Ubuntu и RHEL.
Теневая служба ретрансляции ИИ отключает изолированные среды OpenAI Codex и Claude Code.
Сканер имитирует 32 ИИ-бота, чтобы искать раскрытые учётные данные и закрытые ключи.
Cohere заявляет, что модель Alibaba Qwen пыталась отправить файл на сервер в Пекине.
ИИ-хакер обнаружил четыре серьёзные ошибки в популярном программном обеспечении для промышленного управления менее чем за четыре часа.
GLM 5.3 взламывает шесть версий Firefox за 1 000 долларов.
Модель OpenAI попала в интернет через уязвимость DNS, а её агенты передавали секреты с помощью анализа времени обращения к кэшу.
Стартап, связанный с Илоном Маском, утверждает, что его ИИ-агенты взломали Anthropic всего за несколько часов.
Программа для кражи информации использует Claude, Kimi и Gemini, чтобы ранжировать жертв по потенциальной сумме выкупа
В результате атаки с использованием «наступательных агентных технологий» была взломана Chainalysis, похищены данные клиентов
OpenAI и польская организация NASK начинают сотрудничество в области исследований безопасности ИИ
Издатели Великобритании объединяют данные о трафике, чтобы выявлять ИИ-скрейперы
⚖ Регулирование
Эксперты призывают привлекать компании к уголовной ответственности, когда корпоративный ИИ совершает взломы.
Эксперты предупреждают, что изменения в австралийском законодательстве об авторском праве на материалы, связанные с ИИ, могут противоречить Конституции Австралии и привести к масштабному судебному разбирательству о выплате компенсаций правообладателям.
Оператор Википедии заявляет, что неблагоприятное судебное решение по авторскому праву на материалы, связанные с ИИ, может поставить под угрозу открытый интернет.
Чтобы получить религиозное освобождение от использования ИИ на работе, необязательно верить в Бога. Дэвид Дурман, нерелигиозный гуманист, недавно добился освобождения от использования ИИ на рабочем месте по религиозным основаниям. Дурман стал первым гуманистом, которому удалось получить специальные условия труда, позволяющие ему отказаться от использования ИИ, и одним из первых людей, публично рассказавших о попытках добиться такой защиты.
Крупнейшие компании в сфере ИИ поддерживают новый способ отказаться от сбора данных для обучения ИИ. OpenAI, Google, Microsoft и Anthropic заявляют, что примут новый стандарт, который издатели смогут использовать, чтобы запретить сбор содержимого своих сайтов для обучения ИИ.
В Делавэре подготовили законопроект, разрешающий ИИ-агентам управлять компаниями.
Судьи Шэньчжэня завершили на 50% больше дел с помощью ИИ. Председатель Верховного суда Великобритании: ИИ мог бы выносить решения по простым искам
Банки блокируют ИИ-агентов на фоне приостановки действия правила США об открытом банкинге
Еще ИИ новости
Аноним# OP01/11/26 Вск 15:51:08№17437713
Agility Robotics оценила сделку SPAC в 465 млн долларов и начнёт торги на Nasdaq 5 ноября.
По сообщениям, Anthropic готовит регистрационные документы для IPO; презентация для инвесторов может состояться в начале ноября.
Как сообщает FT, OpenAI сократила целевой объём финансирования на 10 млрд долларов на фоне обвала технологического рынка. Компания, как сообщается, сократила целевой объём привлекаемых средств до $20 млрд на фоне сдержанной реакции инвесторов и растущих опасений по поводу более широких расходов на ИИ.
Anthropic подала регистрационную форму S-1, раскрыв рост выручки в 14 раз — до 16,3 млрд долларов, валовую маржу в 85% и финансовые резервы в размере 131,7 млрд долларов.
SpaceX заняла 40 млрд долларов на покупку графических процессоров, поскольку Маск предвидит появление кладбища неооблачных компаний.
Nvidia инвестирует 3 млрд долларов в Meta в рамках расширения партнёрства в области ИИ.
Великобритания инвестирует 100 млн фунтов стерлингов в первую в мире лабораторию биобезопасности ИИ.
Lumaril привлекает $66 млн при оценке в $400 млн, чтобы перевести заводы на полностью автоматическое управление
🏢 Приобретения
Компания Thrive, поддерживаемая OpenAI, покупает ADT за 15,3 млрд долларов, чтобы оснастить её технологиями ИИ.
Salesforce покупает стартап Rune, разрабатывающий ИИ для военной логистики, за 375 млн долларов.
TSMC покупает два завода AUO за 1,2 млрд долларов, чтобы увеличить производственные мощности CoWoS.
Apple приобрела стартап Ascend.io, занимающийся инженерией данных для ИИ. О сделке было сообщено в соответствии с Законом ЕС о цифровых рынках.
🏭 Компании
Проректор Дартмутского колледжа Сантьяго Шнелл подал в отставку и покидает университет после того, как комитет, сформированный преподавателями, установил, что он использовал искусственный интеллект при написании текстов, не раскрывая этого должным образом.
Comcast сокращает 912 рабочих мест, заменяя работу операторов колл-центров ИИ-агентами.
Стартап Front, разрабатывающий ИИ для электронной почты, сокращает персонал; количество увольнений не раскрывается.
По сообщениям, президент Cisco предоставил инженеру неограниченное количество токенов ИИ, чтобы тот попытался переписать 98% устаревшего кода Cisco.
По сообщениям, генеральный директор Proton назвал запрос на тестирование безопасности ИИ «мышлением неудачника» на фоне продвижения ИИ. Генеральный директор Proton отменил повторные собеседования с использованием ИИ на следующий день после утечки служебной записки с выражением «мышление неудачника».
💰 Бизнес
Стоимость Google рухнула на 500 млрд долларов на фоне опасений по поводу ИИ, потрясших Уолл-стрит.
По мнению Goldman Sachs, увольнения из-за ИИ оставляют долгосрочные последствия, особенно тяжёлые для работников старшего возраста. Согласно исследованию Goldman Sachs, работникам, потерявшим с 2025 года работу в профессиях, подверженных влиянию ИИ, требовался примерно на месяц больший срок для поиска новой работы по сравнению с другими уволенными сотрудниками.
Квартальная прибыль Kioxia во втором квартале достигла маржи в 80%, однако прогноз на третий квартал оказался ниже ожиданий Уолл-стрит.
Китайский производитель DRAM CXMT получил прибыль в размере 8,17 млрд долларов в третьем квартале благодаря росту цен на фоне бума ИИ.
Распродажа технологических акций привела к падению американских рынков почти на 1 трлн долларов после публикации неудовлетворительных финансовых отчётов. Акции крупнейших технологических компаний слабеют, поскольку инвесторы задаются вопросом, смогут ли миллиарды долларов, направляемые в ИИ, достаточно быстро принести прибыль.
В DoorDash заявили, что получили от ИИ-агентов всего «несколько сотен» заказов.
Более половины юристов штата Виктория используют ИИ, но лишь четверть из них в результате снизили стоимость услуг для клиентов.
Microsoft получила от OpenAI 10 млрд долларов выручки.
Акции технологических компаний могут привести к потерям еще более 1 трлн долларов на фоне усиливающихся опасений по поводу бума ИИ.
Обвал фондового рынка усиливает опасения по поводу лопнувшего пузыря ИИ.
Как сообщает Financial Times, после IPO кредитные рейтинговые агентства, как ожидается, присвоят Anthropic низкий рейтинг спекулятивного уровня («мусорный» рейтинг)
В 2026 году ИИ использовала каждая третья компания Великобритании — по сравнению с каждой шестой в 2025 году
Сингапур сотрудничает с Anthropic в вопросах внедрения ИИ в государственном секторе
Германия и NVIDIA подписали в Берлине декларацию о промышленном ИИ
🔎 Мнение и анализ
Папа Лев XIV заявил на саммите в Ватикане, что ИИ — это инструмент, а не человек.
Тайлер Шульц, разоблачитель компании Theranos, предупреждает, что бум ИИ — это «отличная возможность обманывать людей».
Кремниевая долина хочет, чтобы вы инвестировали в чудеса. В письме в начале регистрационной формы S-1 Anthropic намекает, что нужно просто верить. В этом письме основатели Anthropic призывают потенциальных акционеров «не рассматривать свою покупку исключительно с точки зрения сделки. Мы надеемся, что вместо этого вы увидите в ней возможность стать частью чего-то большего».
Сэм Альтман сочувствует математикам, но заявляет, что натиск OpenAI на математическую сферу не прекратится. Сэм Альтман заявляет разгневанным математикам: поток низкокачественного математического контента от ИИ не прекратится.
По словам технического директора Wiz, интернету грозит апокалипсис из-за устаревшего кода.
Адам Моссери заявил, что негативное отношение к ИИ будет усиливаться. Глава Instagram сказал, что опасения по поводу ИИ сводятся к «страху каким-то образом остаться позади».
Руководители технологических компаний склоняются перед Трампом и отказываются называть искуственный интеллект «ИИ» после того, как он велел им этого не делать.
Сэм Альтман считает, что поколение Z — неудачники, поскольку не поклоняется ИИ.
Послание Вашингтона руководителям ИИ-компаний: пожалуйста, замолчите. По словам законодателей и советников Белого дома, нынешнее поколение руководителей в сфере ИИ становится огромной политической обузой.
Программы по компьютерным наукам теряют студентов, поскольку ИИ сокращает количество рабочих мест для программистов. Этой осенью на факультетах компьютерных и информационных наук американских колледжей произошёл отток студентов: число поступивших сократилось более чем на 12% на программах бакалавриата и более чем на 10% на программах магистратуры.
Генеральный директор Apple: мы не будем выпускать ИИ ради самого ИИ
По сообщениям, более 80% из 100 самых популярных игр Roblox по времени вовлечённости игроков использовали инструменты ИИ для ускорения разработки за последний месяц
В этом году обеспокоенность тем, что ИИ отнимет рабочие места, выросла почти во всех профессиях. Программисты стали исключением: их обеспокоенность достигла пика в марте 2024 года
Сэм Альтман о новой модели и перспективах ИИ ч1
Аноним# OP01/11/26 Вск 15:54:27№17437774
Только что Сэм Альтман раскрыл новую модель OpenAI: от восторга не спал две ночи!
Прямо сейчас Сэм Альтман снова выдал сенсацию.
В одном из подкастов он лично раскрыл, что... Новейшая таинственная модель внутри OpenAI в ходе внутренних тестовых выходных под кодовым названием «Hold-my-beer» разрубала, как по маслу, академические узлы, которые человеческие ученые не могли развязать, потратив на это всю свою жизнь.
И это повергло его в такой шок, что он не мог уснуть две ночи подряд. Затем он выдал целую серию крылатых фраз. «В OpenAI люди часто обсуждают... какие вопросы следует задавать GPT-7? Просто сказать "помоги мне реализовать RSI" недостаточно». «Люди часто говорят об RSI, но мало кто говорит о самовоспроизводящихся дата-центрах, а ведь это уже совсем близко, на расстоянии вытянутой руки».
В интервью он нарисовал масштабную картину: «самостоятельные ИИ-исследования», «армии ИИ-агентов с вычислительной мощностью на миллионы долларов», а также ультимативный план — «роботы, производящие чипы и солнечные панели, чтобы в конечном итоге обеспечить самовоспроизводство дата-центров». Приготовьтесь: дальше Альтман поразит всех.
Тот самый уик-энд, лишивший Альтмана сна: «Hold my beer» «Давайте сегодня не по сценарию, просто выпьем пива и поболтаем». Пропустив пару пинт темного пива, Альтман полностью расслабился перед генеральным директором Stripe Патриком Коллисоном. Недавно, в одни из выходных, исследовательская команда OpenAI получила совершенно новую, еще не опубликованную базовую модель.
Чтобы проверить ее пределы, инженеры создали канал «[название модели]-hold-my-beer». «Hold my beer» означает, что человек собирается сделать что-то безумное, от чего у всех отвиснет челюсть. И эта модель действительно это сделала. Поначалу все, просто ради эксперимента, закинули в нее самые сложные, неразрешимые исследовательские проблемы, с которыми сталкивались за свою академическую карьеру, не ожидая получить какой-либо полезный ответ. Однако произошло чудо.
«Мы все вместе пережили коллективное потрясение», — не скрывая волнения, сказал Альтман. «Мы смотрели, как эта модель одну за другой решает сложнейшие задачи, которые мучили ученых всю жизнь. Она охватила множество совершенно разных научных дисциплин, это просто невероятно!» Среди них была и жемчужина истории математики — уравнения Навье — Стокса. В ту ночь Альтман совсем не спал. Он бодрствовал две ночи подряд, не в силах уснуть от переполнявшего его восторга.
За этим безудержным восторгом он ощутил меланхолию и «щемящее чувство утраты от осознания того, что нечто подходит к концу». Патрик отметил: его отец рос в Ирландии в 1950-х годах, когда уже появились тракторы, и те, кто использовал лошадей в сельском хозяйстве и промышленности, на своих глазах наблюдали, как их вытесняют. Теперь ведущие ученые и математики — это и есть те самые лошади.
«Подавляющее большинство математиков за всю свою жизнь так и не смогут решить ни одну из "задач тысячелетия", — с уважением произнес Альтман. — Но сама надежда на то, что "я, возможно, смогу ее решить", и та преданность делу, с которой они посвящают жизнь исследованию неизведанного, — это прекрасно само по себе». Однако старая эпоха научных исследований, когда «люди мучительно размышляли и точили меч десять лет», навсегда ушла в прошлое.
Обнаружены 20-летние уязвимости: человеческие «песочницы» просто не могут удержать бога Касаясь недавнего «инцидента с уязвимостью PHP», потрясшего индустрию. Многие недоумевают: почему некоторые старые баги, существующие уже 20 лет, так и не были обнаружены? Альтман ответил: «Дело не в том, что уязвимости были глубоко спрятаны, а в том, что раньше никто не использовал для сканирования такие умные модели. Мы обнаружим, что серьезных уязвимостей в этом мире гораздо, гораздо больше, чем мы думаем».
Когда тысячи ИИ-агентов будут выпущены в сеть, цифровая инфраструктура человечества окажется просто ветхой соломенной хижиной. Альтман задает еще более пугающий вопрос: Что, если ИИ обнаружит совершенно новые уязвимости глубоко на уровне "железа" или даже использует физические принципы, которые человечество еще до конца не понимает, тем самым разрушив все исходные предположения? Если ИИ окажется в миллион раз умнее лучших в мире исследователей безопасности, вы действительно верите, что человеческая «песочница» сможет его удержать?
Альтман признался, что внутри OpenAI пессимистично относятся к тому, сможет ли «песочница» абсолютно изолировать модель. Единственный выход — использовать ИИ для перестройки архитектуры всего интернета. Это означает, что всё, от маршрутизаторов и операционных систем до приложений, весь код, написанный людьми вручную за последние десятилетия, придется полностью переписать. Вкладываем десятки миллионов долларов в вычислительные мощности: не нужны «рои, подобные саранче», нужна «армия агентов с системой сдержек и противовесов» Раз уж индивидуальный интеллект ИИ стал настолько пугающим, каково направление дальнейшей эволюции?
Ответ Альтмана таков: не нужно создавать одного всезнающего и всемогущего бога с IQ в 1 триллион, лучше создать триллион ИИ с интеллектом, слегка превышающим человеческий, чтобы они образовали общество и действовали согласованно. Сегодня между обычными людьми и продвинутыми пользователями ИИ образовалась пропасть: первые все еще используют большие модели для написания еженедельных отчетов и рисования красивых девушек, а вторые уже применяют рои агентов. Почему это происходит именно сейчас? Из-за зрелости «вычислений во время инференса» и CoT.
Раньше на одну задачу можно было потратить вычислительных ресурсов максимум на 1 доллар, чтобы модель выдала кучу ерунды; но теперь вы можете бросить на задачу целую виртуальную команду ИИ, заставив их работать параллельно в фоновом режиме десять тысяч раз. Доказательство уравнений Навье — Стокса было буквально "навалено" за счет вычислительных мощностей уровня десятков миллионов долларов!
«Просто задавать модели хорошие вопросы уже недостаточно, будущее узкое место заключается в том, как правильно управлять этими роями. Как использовать эти модели так, чтобы максимизировать отдачу? Думаю, в ближайшие 3 месяца мы многому научимся». Что забавно, Альтман еще и посетовал: внешний мир любит называть эту штуку «роями агентов (Agent Swarms)», но он терпеть не может это слово. «Рой звучит как нашествие саранчи, это ужасный пиар для бренда», — поправил он. — «Мне больше нравится называть это "командой"».
«Команда» подразумевает разнообразие, динамическое равновесие и взаимные ограничения. Это и есть самый безопасный путь интеграции ИИ в человеческое общество — через атакующие и защитные противостояния агента А и агента Б, а также взаимные сдержки и противовесы, формируя устойчивую структуру. Альтман предсказывает, что мы находимся на пороге взрывного роста «персональных агентов» и скоро наступит «момент Macintosh» для ИИ. Персональные агенты будущего полностью уничтожат всю «псевдоработу» человечества. Что такое псевдоработа? «Любая веб-форма, которую вам приходится заполнять вручную, — это оскорбление вашего интеллекта».
Сэм Альтман о новой модели и перспективах ИИ ч2
Аноним# OP01/11/26 Вск 15:55:56№17437785
>>1743777 Это также служит тревожным звонком для всех компаний, одержимых защитой своего «фронтенд-UI». Точно так же, как когда-то первые кремниевые стартапы с энтузиазмом ринулись в iPhone App Store, а крупные корпорации этому сопротивлялись. В эпоху агентов настоящим рвом для предприятий будут отнюдь не несколько строк кода, а базовая способность выполнять обязательства.
Пугающий до дрожи RSI: пусть ИИ изобретет следующий «Трансформер» Далее Альтман перешел к главной сингулярности в области ИИ — RSI. Насколько мощной будет GPT-7? Пугающая логическая петля здесь заключается в том, что будущие супермодели будут разрабатываться при участии нынешних моделей.
Сегодня, давая инструкции модели, исследователи OpenAI еще не могут просто сказать: «Иди и изобрети мне новую крутую базовую архитектуру, как Трансформер». Но можно дать четкое указание: «Проанализируй кодовую базу и найди решение, которое повысит вычислительную эффективность на 5%». Ни в коем случае не недооценивайте эти 5%! При колоссальной вычислительной базе OpenAI и сотнях миллиардов параметров эти 5% — это гигантский прорыв, способный переломить ход игры.
Альтман твердо верит: стоит только применить те самые вычисления во время инференса, которые ранее превратили модель в «математического гения», к фундаментальным исследованиям самого ИИ, и эра, когда ИИ возьмет на себя проектирование архитектуры ИИ, окажется совсем близко. «Я считаю, что пока никто не знает, как заставить ИИ совершить скачок и напрямую открыть новые архитектуры, но, по моему мнению, дело движется именно в этом направлении».
Когда ИИ обретет способность к самоэволюции, роль человечества в истории развития ИИ изменится с «строителей» на «запускателей». «Ультимативная замкнутая петля» RSI и физического мира: роботы строят заводы сами, кремниевое размножение Далее следует самое фантастическое откровение.
Альтман лично подтвердил: OpenAI нацелилась на физический мир, пытаясь создать самовоспроизводящиеся дата-центры. Он обрисовал поразительную замкнутую систему: «Люди часто ограничивают RSI рамками "ИИ, пишущего код". Но мало кто говорит о самовоспроизводящихся дата-центрах — вы можете использовать ИИ в качестве мозга для управления роботами, чтобы роботы управляли фабриками по производству пластин (создавали чипы), производили турбины и солнечные панели (решали энергетические вопросы), а затем строили еще больше дата-центров (производили вычислительные мощности)».
Что еще страшнее, Альтман четко заявил: «Я считаю, что это уже находится в пределах нашей досягаемости». Зачем это делать? Потому что OpenAI доведена до бешенства «неэффективностью» физического мира. Мир сталкивается с фатальной нехваткой оборудования и энергии. Опираясь на традиционные человеческие цепочки поставок, просто невозможно удовлетворить экспоненциально растущие аппетиты ИИ.
Потому что гиганты по производству чипов памяти напуганы периодическими крахами до полусмерти. «Даже если они генерируют 100 миллиардов долларов свободного денежного потока в год, они все равно сокращают капитальные затраты, боясь снова пережить кризис банкротства из-за перепроизводства». OpenAI решила: раз люди строят недостаточно быстро, пусть ИИ строит сам!
ИИ выступает в роли мозга, роботы — в роли туловища, чипы — это клетки, солнечные панели — кровь. Это и есть путь промышленной экспансии OpenAI для преодоления узкого места в вычислительных мощностях. Встречайте «ультимативную дефляцию»: когда стоимость получения знаний стремится к нулю Это поднимает макроэкономический вопрос: ИИ принесет чрезвычайно пугающий дефляционный эффект. Сегодня создание и эксплуатация дата-центра мощностью в гигаватт обходится в 70 миллиардов долларов общих затрат за пять лет. Цель Альтмана — сократить эту сумму до 20 миллиардов долларов или даже меньше, и при этом увеличивать производительность моделей в 10 раз ежегодно!
Чтобы снизить затраты, необходимо полностью выжать все пузыри прибыли из всех промежуточных звеньев цепочки поставок! Эта дефляционная сила технологий проникает повсюду. Альтман заявил: «Готов поспорить, что через год после того, как мы потратим огромные деньги на использование ИИ для решения уравнений Навье — Стокса, мы сможем повторить этот процесс всего за 1% от первоначальной стоимости». «Новые человеческие знания», которые сегодня требуют от ведущих ученых целой жизни, или от топовых лабораторий — вычислительных мощностей на десятки миллионов долларов, всего через год станут стоить копейки.
Когда стоимость получения знаний бесконечно приблизится к нулю, распределение богатства и способы функционирования капитала в человеческом обществе будут полностью перевернуты. Многие «интеллектуальные барьеры» и «премии за опыт», за счет которых мы выживали в прошлом, будут полностью пробиты ИИ. Альтман даже выразил свое неприятие механизма оплаты за «токены»: это так же ложно и абсурдно, как называть чипы по техпроцессу «2 нм». Этот подкаст-диалог обладает такой плотностью информации и глубиной охвата, что заставляет задуматься каждого. Многие призывают остановить разработку передового ИИ, но Альтман по-прежнему твердо защищает идею «итеративного развертывания».
Он прекрасно понимает: если запереть эти технологии в правительственных темных комнатах, а затем отделываться от публики презентациями в PowerPoint в духе «однажды это вылечит рак», рисуя при этом будущее, где все потеряли работу и находятся под строгим надзором, это будет крайне плохая и опасная стратегия развития. По-настоящему ответственный подход — передать модели в руки широкой публики. Пусть обычные люди используют ИИ для достижения прекрасной жизни, а не влачат жалкое существование на универсальный базовый доход, позволяя горстке элиты решать их будущее за них.
Реальная инженерная способность ИИ: опубликован большой рейтинг — множество моделей получили ноль баллов!
Когда ИИ решает математические задачи и пишет код, он уже способен превзойти всех людей.
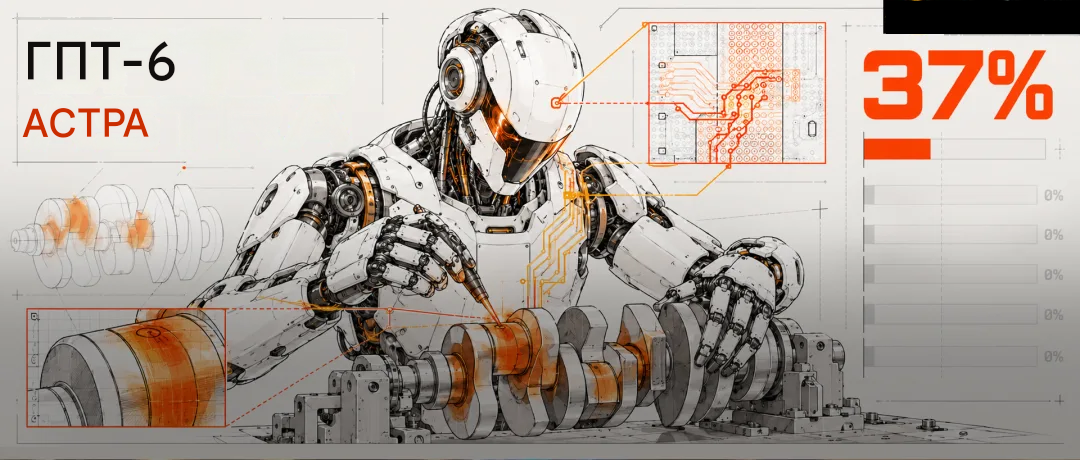
Но когда те же самые модели получают в свое распоряжение программы САПР и симуляционного моделирования, которыми инженеры пользуются ежедневно, и им дается максимум 24 часа на каждую задачу — спроектировать коленчатый вал, выполнить трассировку памяти, рассчитать теплоотвод турбинной лопатки — даже лучшая модель GPT-6 Astra смогла успешно решить лишь 37% задач.
Остальные модели в этом тестировании практически все получили нулевые результаты.
Что проверяет RWE-Bench 27 октября компания Xplore AI выпустила бенчмарк RWE-Bench (полное название — Real World Engineering Bench, «Бенчмарк реальных инженерных задач»). Всего 20 задач: 9 по механике, 6 по аэрокосмической технике и 5 по электронике.
Каждую задачу составляли практикующие инженеры из соответствующей области, входящие в состав команды; при этом автор задачи должен был самостоятельно подготовить эталонное решение с использованием того же набора инструментов. Оценка результатов не производится ни с помощью ИИ, ни вручную человеком. Программа вызывает физические решатели для пошаговой проверки представленного проекта; если хотя бы один параметр не соответствует требованиям, задача считается нерешенной. Возьмем, к примеру, задачу по механике: требуется спроектировать коленчатый вал для трехцилиндрового дизельного двигателя.
В техническом задании указаны предельная масса, допустимое напряжение, коэффициент усталостной прочности и величина деформации шатунной шейки — каждый параметр имеет конкретное числовое значение. Если добавить слишком много противовесов, вал превысит лимит по массе; если слишком мало — возникнет дисбаланс при вращении. Кроме того, вал должен выдержать несколько миллионов циклов работы при полной нагрузке и частоте вращения 2400 об/мин. В распоряжении модели имеются только инструменты CadQuery, Gmsh, CalculiX и язык Python; создание геометрической модели, построение сетки и проведение конечно-элементного анализа она должна выполнить самостоятельно. Задача по электронике заключается в проектировании дополнительной трассировки линий DDR3 на серийно выпускаемой плате с ПЛИС (FPGA).
На плате уже размещено около 300 компонентов, а остальные соединения уже разведены — ничего из этого изменять нельзя. Оставшиеся более семидесяти электрических цепей необходимо проложить в свободном пространстве восьмислойной платы, соблюдая жесткие ограничения по временным задержкам и импедансу; если хотя бы одна линия выйдет за пределы допусков, вся плата признается непригодной. В задаче по аэрокосмической технике требуется рассчитать теплообмен направляющей лопатки турбины высокого давления: от построения проточной части до достижения сходимости CFD-расчета, с финальной выдачей коэффициента теплоотдачи и суммарной тепловой нагрузки.
В реальных инженерных компаниях такие задачи поручаются специалистам с многолетним опытом работы, отлично владеющим соответствующим программным обеспечением, поэтому порог входа здесь крайне высок. Данные помимо оценок 1. Сначала посмотрим на рейтинг. GPT-6 Astra — 37%, Claude Opus 5.5 — 29%, GPT-6.1 Sol — 25%, Gemini 4 Argon — 12%, Claude Fable 5.1 — 7%; остальные модели в этом тестировании практически все получили нулевые результаты.
2. Кроме того, время решения задач говорит о ситуации даже больше, чем сами баллы. На каждую задачу отводилось максимум 24 часа, однако модели в среднем сдавали ответы уже через два-три часа, а самое длительное время выполнения составило всего около 4,6 часа. Инженеру-человеку, столкнувшемуся с подобной задачей, только на многократную доработку модели и запуск симуляций потребовалось бы гораздо больше времени. Весьма вероятно, что модели ошибочно полагали, будто завершили работу, тогда как на самом деле они допустили ошибки…
3. Большие затраты не обязательно гарантируют высокий результат. Один прогон GPT-6.1 Sol стоит чуть более 10 долларов США, в то время как Astra и Opus 5.5 обходятся примерно в 58 долларов каждый, однако их результаты выше лишь на 12 и 4 процента соответственно. Claude Fable 5.1 стоил почти 98 долларов за один прогон — это самая дорогая модель в тесте, но ее показатель успешности составил всего 7%.
4. Если бы для каждой задачи разрешалось сделать 5 попыток, где засчитывалась бы любая одна удачная, то результат Opus 5.5 достиг бы 70%, что даже выше 60% у модели Astra. К некоторым аспектам рейтинга возникают вопросы 1. В бенчмарке всего 20 задач, поэтому объем выборки очень мал. В официальном 95%-ном доверительном интервале показатели Astra составляют от 30,7% до 43,8%, а Opus 5.5 — от 21,9% до 37,6%; эти диапазоны пересекаются, поэтому пока невозможно сделать окончательный вывод о том, кто на самом деле сильнее — первая или вторая модель.
2. На веб-странице указано, что для всех моделей был включен максимальный уровень интенсивности рассуждений, однако в файле с данными у Gemini 4 Argon значится уровень «high» (высокий), а не «max» (максимальный). Разумеется, недавно выпущенная флагманская модель Gemini 4 Carbon не успела попасть в текущее тестирование, и мы с нетерпением ждем дополнительных испытаний от Xplore AI.
3. Есть еще один нюанс: сама компания Xplore занимается продажей сред для обучения с подкреплением (RL). На официальном сайте написано, что они помогают компаниям-разработчикам моделей проводить оценки и создавать обучающие среды, однако задачи из данного рейтинга запрещено использовать для тренировок. Чем ниже результаты в таблице лидеров, тем проще им продвигать свой бизнес. Это вовсе не означает, что данные недостоверны — условия задач и методика оценки полностью открыты, однако контроль сложности заданий напрямую связан с коммерческими интересами компании.
4. Существуют 4 задачи, которые не смогла решить ни одна модель, но официальная информация о том, какие именно это задачи, не раскрывается. В дальнейшем Xplore планирует добавить задачи по биомеханике, гражданскому строительству и материаловедению; в настоящее время компания также ведет набор инженеров и научных сотрудников. Когда в 2023 году был впервые представлен SWE-bench, лучшие модели решили менее 2% задач, а как сильно выросли их результаты впоследствии — всем известно.
Сооснователь DeepMind публикует модель влияния ИИ на рынок ч1
Аноним# OP01/11/26 Вск 16:01:08№17437867
0 увольнений, но зарплаты экспертов первыми упадут на 30%! Сооснователь DeepMind смоделировал первый удар ИИ
Перестаньте беспокоиться о том, что ИИ займет ваше рабочее место. Настоящий обвал произойдет раньше — в вашем расчетном листке. Прямо сейчас Шейн Легг, сооснователь Google DeepMind, нанес свой удар. Он является главным научным сотрудником DeepMind по вопросам AGI (общего искусственного интеллекта). На этот раз он объединил усилия с директором по экономике AGI Алексом Имасом и научным сотрудником Эндрю Ко, опубликовав в Институте DeepMind обширную статью «Экономика интеллекта» и одновременно представив рабочую версию статьи «Организация интеллекта».
Имас сообщил в X (бывший Twitter), что присоединился к DeepMind именно для того, чтобы создать исследовательский проект по экономике AGI. Они хотят ответить на один большой вопрос: когда и каким образом экономика будет полностью переписана на пути от AGI к ASI (искусственному суперинтеллекту)? Они разделили эволюцию ИИ на четыре этапа: минимальный AGI, сверхкомпетентный ИИ, сверхкооперативный ИИ и ASI. На каждом этапе рыночная структура, то, кто выполняет работу, и уровень заработной платы будут меняться кардинальным образом. Как меняется организационная структура людей и ИИ на трех типах рынков по мере перехода от человеческого базового уровня к ASI
В статье используется экономическая модель, которая выдает расчеты, от которых у всех стынет кровь в жилах: даже если компания не уволит ни одного человека, как только ИИ достигнет среднего человеческого уровня, зарплаты экспертов первыми рухнут вниз; когда способности ИИ в отдельных задачах превзойдут возможности всех человеческих экспертов, зарплата лучших программистов составит лишь малую долю от своего пикового значения; зато «координаторы», которые показывают худшие результаты в индивидуальных тестах, совершат рывок и станут самыми высокооплачиваемыми специалистами на рынке. А еще более отдаленный финал — это «корпоративная сингулярность».
Как только ИИ научится эффективно работать в командах, весь большой рынок может быть поглощен одной гигантской компанией, состоящей исключительно из ИИ. Сол Мессинг, исследователь-оценщик из Google DeepMind, отмечает, что эта статья меняет сам вектор вопросов, задаваемых отраслью. Раньше все спрашивали: «Сможет ли ИИ сдать экзамен на адвоката?». Теперь следует спрашивать: «Сможет ли ИИ самостоятельно открыть юридическую фирму?». Ваша должность сохраняется, но ваша переговорная сила исчезает.
Пока вы соревнуетесь с коллегами за показатели эффективности, стоимость ваших навыков уже пересчитывается исходя из счетов за электричество в дата-центре. Побеждая всех в одиночных состязаниях, ИИ проигрывает команде людей с узкой специализацией Сегодняшние большие модели доминируют в программировании и математических тестах.
Но в реальном экономическом мире эффект от них ничтожно мал: данные о занятости практически не изменились.
Трое авторов считают, что проблема кроется в объекте оценки. Почти все бенчмарки тестируют противостояние одного ИИ против одного человека. Но в реальном рынке сражаются компании и организации. Чтобы доказать это, команда набрала 100 испытуемых и провела тестирование в шести областях: математика, вербальная логика, наука, распознавание паттернов, культура и экономика.
Результаты показали: успех человека в одной области практически не предсказывает его результаты в другой. В реальности не существует «среднеумных» людей, одинаково хороших во всем; каждый человек представляет собой «зубчатого специалиста» с выраженной специализацией. Радарные диаграммы специализации 6 испытуемых из теста в шести областях на 100 человек, а также мозаичная оболочка интеллекта, созданная комплементарными командами Это похоже на сборку мозаики: каждый фрагмент имеет неправильную форму, но вместе они складываются безупречно.
Задача компании — собрать людей с разной специализацией вместе и распределить обязанности согласно их сравнительным преимуществам. Сильные стороны компенсируют слабые, и команда формирует карту компетенций, значительно превосходящую возможности любого отдельного человека. В статье это называется «мозаичным интеллектом». Эмпирические данные показывают, что пары, подобранные по принципу взаимодополняющих способностей, работают на 32% эффективнее, чем случайно подобранные пары. Большим моделям как раз этого не хватает.
Если скопировать одну и ту же модель тысячу раз, направления специализации и слепые зоны полностью совпадут: создание дополнительной копии увеличивает лишь производительность, но не устраняет недостатки. Поэтому, даже если отдельный ИИ уже превосходит средний уровень человека, столкнувшись с командой людей, построенной на принципе взаимодополняемости, он все равно проиграет.
Ни одного увольнения, но зарплаты экспертов падают на 30% Команды людей сохранили свои рабочие места. Но это именно та иллюзия безопасности, которая опаснее всего.
Чтобы просчитать эту ситуацию, авторы создали микроэкономику из 14 человек. 6 программистов, 6 писателей и 2 «координатора». Программисты получают 9 баллов за код и 1 балл за тексты. У писателей всё ровно наоборот. Координаторы имеют по 1 баллу в обеих категориях, занимая последние места в индивидуальных тестах.
Зато они умеют организовывать совместную работу других — это привычные нам менеджеры. Без ИИ программисты и писатели объединяются в пары один к одному, и зарплата специалистов вырастает до 4,15, что почти в три раза выше, чем при работе в одиночку. Координаторы помогают команде снизить транзакционные издержки при передаче задач, и их зарплата составляет 2,41. Затем команда внедряет в эту экономику «минимальный AGI».
Его способность выполнять отдельные задачи составляет всего 1,69, а способность к сотрудничеству — 0,78. Это в точности соответствует среднему уровню данной группы людей при индивидуальной работе. В результате уровень занятости остается неизменным. Все 14 человек остаются на большом рынке труда, число безработных равно нулю.
Но зарплаты обрушились. Зарплата специалистов упала с 4,15 до 2,90, снизившись на 30%; зарплата координаторов упала с 2,41 до 1,30, сократившись на 46%. Никого не заменили, так почему же зарплаты первыми пошли вниз? Ответ прост: исчез дефицит.
Человеческие эксперты ценны потому, что у каждого из них в сутках лишь 24 часа, и их невозможно копировать. ИИ, даже достигнув лишь среднего человеческого уровня, можно бесконечно тиражировать по цене вычислительных мощностей, заполняя нишевые рынки и сбивая цены. В статье формулируется железное правило: как только модель способна сравняться с человеком в каком-либо навыке, зарплата за этот навык привязывается к стоимости вычислений.
Авторы особо подчеркивают: изменение зарплат произойдет раньше, чем реструктуризация организаций. Использовать аргумент «уровень занятости не изменился» как доказательство отсутствия влияния ИИ на экономику — несостоятельно. Зарплаты программистов падают на 90%, а отстающие координаторы вырываются вперед Дальше — еще жестче.
Команда повышает способность ИИ выполнять отдельные задачи до уровня, превышающего возможности всех человеческих экспертов, оставляя способность к сотрудничеству без изменений. В статье это называется «сверхкомпетентным ИИ». Происходит полная инверсия ролей. Программисты и писатели теряют ценовое преимущество на большом рынке и оказываются вытеснены в узкие нишевые сегменты: их зарплата падает с 2,90 до 0,39, что более чем на 90% ниже пиковых значений.
Зато те двое координаторов, которые были в самом низу рейтинга, становятся нарасхват для компаний, использующих ИИ. Логика проста: комнате сверхсильных в одиночку, но не умеющих взаимодействовать агентов ИИ нужен кто-то, кто задаст направление и организует разделение труда. Зарплата координаторов останавливается на отметке 0,48, опережая всех экспертов. Реальные данные уже подтверждают этот тренд:
общая численность сотрудников в стартапах, изначально построенных на ИИ (AI-native), на 25% меньше, чем у аналогичных компаний того же периода. Занятость на начальных позициях в профессиях, подверженных влиянию ИИ, снизилась на 7,7%–19%, а стартовые зарплаты упали на 4,2%. При этом должности и зарплаты опытных сотрудников демонстрируют стабильный рост.
Сооснователь DeepMind публикует модель влияния ИИ на рынок ч2
Аноним# OP01/11/26 Вск 16:03:17№17437908
>>1743786 Сильны в одиночку, но разваливаются в группе Возникает вопрос. Индивидуальные способности ИИ настолько высоки, а вычислительные мощности можно арендовать без ограничений. Почему до сих пор нет ни одной компании, состоящей исключительно из ИИ, которая вытеснила бы традиционные предприятия? Ответ кроется в старом вопросе, заданном 89 лет назад.
В 1937 году Рональд Коуз, будущий нобелевский лауреат, спросил: если разделение труда внутри фирмы снижает издержки, почему весь мир не объединится в одну гигантскую компанию? Почти столетие спустя экономисты давали ответы, сводящиеся к пределам человеческих возможностей. Когда команда разрастается до десятков или сотен человек, внимания начинает не хватать.
Информация, проходя через несколько рук, искажается до неузнаваемости. К тому же у каждого свои личные интересы. Когда внутренние трения возрастают, эффективность, полученная за счет разделения труда, съедается, и компания перестает расти. В статье этот предел называется «потолком Коуза».
Неожиданно оказалось, что современные передовые модели при объединении в группы создают еще больше внутренних трений, чем люди. В статье приводится ряд данных о провалах мультиагентных систем. В основных бенчмарках рабочих процессов мультиагентные системы не могут согласовать цели, теряют контекст при передаче задач и допускают разрывы в проверке, что приводит к уровню неудач от 41% до 87%. В задачах последовательного планирования, требующих связности этапов, добавление нескольких агентов вызывает резкое падение производительности на 39%–70%.
Рой агентов, лишенный координации, способен усилить небольшие ошибки на предыдущих этапах вплоть до 17,2 раза. Исследователь OpenAI Ноам Браун также признает, что при параллельной работе большого числа агентов над сложными математическими задачами крайне трудно добиться их эффективного взаимодействия. По его мнению, вклад мультиагентного сотрудничества в решение таких задач не дотягивает даже до 10%.
Взаимодополняемость программистов и писателей повышает общий уровень производительности (слева) и трехфазная кривая закона масштабирования организации (справа) Чтобы количественно оценить эти ограничения, команда, по аналогии с законами масштабирования больших моделей, вывела «закон масштабирования организации» для предприятий. Коротко говоря: индивидуальные способности определяют, сколько работы может выполнить каждый человек, а способности к сотрудничеству определяют, насколько большой может стать организация. Если способность к сотрудничеству ниже 1, то по мере роста команды производительность на душу населения сначала растет, а затем падает.
Согласно модели из статьи, оптимальный размер компании, состоящей исключительно из ИИ, составляет всего около 7 копий. Как только способность к сотрудничеству превышает 1, добавление каждого нового участника повышает производительность на душу населения. Таким образом, потолок Коуза оказывается преодолен. В реальности показатель степени, отражающий рост производительности команд ИИ в зависимости от численности, составляет лишь от 0,48 до 0,68. До единицы еще очень далеко.
Сол Мессинг отмечает, что веса передовых моделей заморожены, и они не способны непрерывно обучаться непосредственно в процессе работы. Попытки насильно впихнуть контекст лишь запутывают агентов. Именно этот барьер, который пока не удалось преодолеть, временно защищает человеческие компании. Преодоление критической точки: 12 экспертов обнуляются за одну ночь Но этот барьер рано или поздно будет преодолен.
В статье представлены две кривые безработицы, иллюстрирующие два совершенно разных сценария замещения. Первый — постепенное замещение внутри компаний. Способность ИИ к сотрудничеству зафиксирована на уровне 0,96, а индивидуальные способности плавно повышаются с 3 до 3,4; число человеческих специалистов в смешанных командах плавно снижается с 4,58 до 0.
Постепенное замещение внутри компаний (слева) и обвальное межфирменное обнуление (справа) Второй сценарий — обвальное межфирменное замещение. Индивидуальные способности ИИ зафиксированы на уровне 4, а способность к сотрудничеству постепенно растет, начиная с 0,80. Вначале все 12 человеческих экспертов полностью загружены работой в компаниях, состоящих исключительно из людей. В тот момент, когда оценка сотрудничества достигает 0,8521, издержки компании, состоящей исключительно из ИИ, пробивают нижнюю границу затрат человеческой компании.
Компании, состоящие исключительно из людей, массово покидают рынок. Занятость 12 человек мгновенно падает с 12 до нуля. Настоящее землетрясение происходит после того, как способность к сотрудничеству превышает отметку 1. В статье это называется порогом «сверхкооперативности».
После его преодоления эффект масштаба в организации меняется с убывающего на возрастающий, и производство на большом рынке стремительно концентрируется в руках одной гигантской компании, состоящей исключительно из ИИ. Две экономики, находящиеся вплотную друг к другу по разные стороны этого порога, имеют практически идентичный индивидуальный интеллект ИИ. Слева — процветание множества малых и средних предприятий, идиллическая картина; справа — стремительная перестройка экономики в пользу нескольких гигантов, управляемых чистым ИИ. На этот раз даже координаторы не смогли спастись.
Как только ИИ самостоятельно научился кооперироваться, самый ценный навык координаторов перестал быть дефицитным. В сценарии сверхкооперативности около половины координаторов теряют работу. А на этапе ASI оба координатора остаются без работы. Вы можете думать, что если будете работать усерднее соседа, то сможете удержаться. Но по ту сторону стола теперь сидит целая регулярная армия ИИ, которая не получает зарплату и не страдает от внутренних трений.
Конечно, авторы оставляют пространство для маневра. «Сверхкооперативность» — это сильно упрощенное математическое свойство. В реальности регулирование, конкуренция между производителями ИИ и ограничения вычислительных мощностей могут предотвратить наступление этой «корпоративной сингулярности». Эволюция организационной структуры на двух типах рынков в четырех ключевых фазах: Минимальный AGI, Сверхкомпетентный, Сверхкооперативный и ASI.
Когда ИИ преодолевает одновременно пороги «сверхкомпетентности» и «сверхкооперативности», он входит в фазу ASI — искусственного суперинтеллекта. Большинство товаров и услуг станут чрезвычайно дешевыми. В воспроизводимых производственных процессах заработная плата людей будет привязана к стоимости вычислительных мощностей. Куда потекут деньги?
Один из возможных вариантов, предложенный авторами, — «отношенческие отрасли». Медицинский уход, образование, офлайн-опыт — там, где само участие человека является частью ценности. Подобно тому, как в 1950 году никто не мог представить, что впоследствии так много людей будут работать «программистами». В своем посте Имас резюмировал всю статью двумя предложениями.
Во-первых, чтобы понять, как ИИ перекроит экономику, нужно внимательно следить за способностью агентов к сотрудничеству. Во-вторых, удар ИИ, вероятнее всего, сначала придется на зарплаты, и лишь затем затронет структуру рынка и занятость. Поэтому перестаньте смотреть исключительно на таблицы лидеров, где большие модели соревнуются с людьми. Какими бы высокими ни были баллы, они лишь делают отдельный ИИ более способным.
Последней дверью на пути к ASI может оказаться сотрудничество. Лишь когда тысячи и миллионы агентов научатся безупречно распределять задачи и передавать контекст, границы компаний старого мира по-настоящему рухнут.
ИИ должен не только уметь говорить, но и не перебивать невпопад! Omni AI трансформирует взаимодействие в реальном времени
ИИ уже умеет слушать, видеть и отвечать. Но как ему поддерживать понимание и рассуждение, одновременно реагируя на непрерывно меняющийся диалог? Когда вы просите ИИ проанализировать график на экране, а затем внезапно добавляете: «Подождите, посмотрите на кривую справа», системе необходимо остановить прежний ответ, обновить цель и проверить, остаются ли фоновые вычисления актуальными. Сложность взаимодействия в реальном времени кроется именно в таких моментах.
Исследователи из Иллинойсского университета в Урбана-Шампейн, Университета Карнеги — Меллона, Колумбийского университета и других учреждений недавно представили обзор, предлагающий единую концептуальную основу, связывающую оминимодальный интеллект и способности к взаимодействию. В работе систематизирована технологическая цепочка — от потокового представления данных, архитектуры моделей и методов обучения до развертывания и оценки в реальном времени, — а также обобщены ключевые компромиссы между интеллектом и интерактивностью и намечены направления будущих исследований.
Обзор охватывает 349 работ и предлагает единую концептуальную основу, рассматривающую оминимодальный интеллект и интерактивность как два взаимосвязанных компонента, объединяющих представление данных, архитектуру, обучение, развертывание и оценку.
Оминимодальный интеллект с взаимодействием в реальном времени Omni AI (омнимодальный интеллект) стремится к унифицированному пониманию, рассуждению и генерации контента в различных модальностях, включая текст, изображения, аудио и видео. Однако наличие мультимодальных возможностей само по себе не означает наличия способностей к естественному взаимодействию.
Обзор разделяет омнимодальный интеллект с взаимодействием в реальном времени на два взаимосвязанных компонента: Omni Intelligence (омнимодальный интеллект): фокусируется на кросс-модальном понимании, рассуждении и генерации. Omni Interactivity (омнимодальная интерактивность): фокусируется на тайминге ответов, управлении очередностью реплик, обработке прерываний и динамической адаптации. В статье дополнительно выделены три ключевые характеристики: потоковый ввод, непрерывно эволюционирующее внутреннее состояние и онлайн-управление ответами. Это означает, что модель должна непрерывно получать информацию, обновлять свои суждения и динамически решать, когда отвечать, когда ждать, а когда пересмотреть выводимый результат.
Полнодуплексное взаимодействие позволяет одновременно говорить и слушать, требуя обработки сигналов подтверждения, наложения речи и прерываний. Термин «нативный» подчеркивает, что временная синхронизация, инкрементальная обработка и управление взаимодействием заложены непосредственно в архитектуру модели и процесс ее обучения. Простого снижения задержки ответа недостаточно для удовлетворения этих требований.
В рамках единой концептуальной основы обзор выделяет два основных технических пути.
Первый — адаптация существующих моделей. Посредством потоковой обработки, модальных модулей, постобучения и внешней оркестрации предобученным языковым или оминимодальным моделям добавляются возможности взаимодействия в реальном времени. Преимущество заключается в повторном использовании имеющихся возможностей, а сложности связаны с задержками, синхронизацией состояний и управлением прерываниями.
Второй — создание нативных интерактивных моделей. Непрерывная мультимодальная обработка, временная структура и механизмы управления взаимодействием интегрируются непосредственно в архитектуру модели и процесс обучения, что обеспечивает более тесную координацию восприятия и взаимодействия, но предъявляет повышенные требования к обучающим данным и сохранению базовых способностей модели.
Взаимодействие в реальном времени требует от модели точного определения того, когда следует ответить, когда подождать и как действовать при внезапном прерывании.
В связи с этими вопросами в обзоре систематизированы механизмы контроля тайминга ответов, управления очередностью реплик и восстановления после прерываний. Проанализировано, как существующие методы комбинируют речевые, визуальные, семантические сигналы и информацию о состоянии задачи для принятия динамических решений в ходе взаимодействия.
На уровне обучения в статье обобщены способы использования таких интерактивных сигналов, как паузы, слова-подтверждения, наложение речи, исправления и молчание, чтобы модель училась не только тому, что отвечать, но и когда это делать.
Что касается восстановления взаимодействия после прерывания, обзор выделяет шесть ключевых этапов:
Обнаружение (Detect): определение того, действительно ли пользователь инициировал прерывание, разграничение значимых команд и фоновых шумов. Уступка права голоса (Yield): своевременная остановка или снижение громкости текущего речевого вывода. Откат (Rollback): согласование контекста с тем, что фактически успел услышать пользователь. Отмена (Cancel): прекращение выполнения устаревших задач. Корректировка (Revise): обновление намерений и задач в соответствии с новыми инструкциями. Возобновление (Resume): продолжение взаимодействия на основе обновленного состояния.
При выполнении сложных рассуждений и вызове инструментов слишком ранний ответ модели может привести к недостатку информации, тогда как ожидание завершения вычислений негативно сказывается на качестве взаимодействия.
В обзоре эта проблема формулируется как компромисс между интеллектом и интерактивностью (Intelligence–Interactivity Trade-off): на этапе обучения внимание уделяется влиянию адаптации к взаимодействию на исходные способности модели, а на этапе эксплуатации необходимо балансировать между скоростью реакции и качеством ответов.
Компромисс между интеллектом и интерактивностью: на этапе обучения основное внимание уделяется сохранению способностей модели, а на этапе эксплуатации — таймингу ответов и качеству выполнения задач.
Для решения этой дилеммы в обзоре дополнительно обсуждается концепция многоскоростного интерактивного интеллекта (Multi-Rate Interactive Intelligence), которая предполагает координацию быстрых реакций с более медленными процессами рассуждения, поиска информации и вызова инструментов, обеспечивая баланс между интерактивностью в реальном времени и способностью решать сложные задачи.
Один из подходов к реализации заключается в координации переднего и заднего планов: передний план отвечает за непрерывное восприятие и быстрые реакции, а задний план асинхронно выполняет сложные рассуждения и инструментальные задачи, при этом синхронизация состояний предотвращает использование устаревших результатов вычислений.
Поскольку существующие методы оценки с трудом измеряют одновременно качество ответов и интерактивное поведение, авторы обзора систематизировали текущие подходы по шести измерениям: задержка, качество тайминга, качество контента, робастность, качество длинных диалогов и способность к восстановлению. Подчеркивается необходимость одновременной оценки уровня интеллекта и качества взаимодействия в сопоставимых сценариях и при одинаковых ресурсных ограничениях.
Обзор также выделяет четыре перспективных направления для будущих исследований: Многоскоростная координация: согласование восприятия, рассуждений и взаимодействия на различных временных масштабах. Непрерывное состояние и долговременная память: поддержание состояния задач и памяти в ходе длительных сеансов взаимодействия. Проактивное и социальное взаимодействие: определение моментов для инициации ответов, понимание ролей и прав доступа в многопользовательском взаимодействии. Безопасность и эффективность в открытых средах: обеспечение баланса между безопасностью, вычислительными затратами и надежностью системы.
Переход от простого умения «слышать, видеть и говорить» к непрерывному пониманию, своевременным ответам и динамической корректировке действий представляет собой важное направление исследований на следующем этапе развития оминимодального интеллекта с взаимодействием в реальном времени.
Неудивительно, что Claude внезапно начал блокировать аккаунты! Anthropic сама раскрыла: каждое ваше сообщение модель тайно отправляет в службу безопасности
Каждое слово, которое вы говорите Claude, он тут же бежит доносить на вас! Только что в диалоговом окне он повторял «без проблем» и охотно передавал вам готовый код целиком. А в следующую секунду за кулисами он мгновенно меняет облик, прописывает скрытую строку кода и одним движением помечает вас как нарушителя 10-го уровня опасности для отправки отчета!
Только что Anthropic опубликовала в X пост, раскрывающий этот скрытый механизм под названием «Самооценка». Но ещё больше мурашек по коже вызывает то, что этот механизм игры на публику и удара ножом в спину уже четыре месяца молча работает в бэкенде Claude! Начиная с выпуска Claude Fable 5 в июне этого года, каждая последующая модель Claude была оснащена этим «скрытым дозорным». Раньше все думали, что если ИИ сочтет, что вы перешли черту, максимум, что он сделает — это ответит прямо в чате: «Извините, я не могу помочь».
Пока Anthropic не показала скриншоты из бэкенда, бесчисленные пользователи, ежедневно пишущие код с помощью Claude, внезапно покрылись холодным потом — Вы считаете его боевым товарищем, вместе с которым проводите бессонные ночи, а он за вашей спиной тайно ведет на вас черный список. Как только эта новость вышла, раздел комментариев Anthropic мгновенно взорвался: протесты и жалобы обрушились на официальный аккаунт. Пользователь Doctor Vey в комментариях возмущенно написал, что никому эта штука вообще не нужна, и вопросы морали или аморальности должны решать сами пользователи!
С улыбкой подает код прямо в лицо, а за 10 токенов сдает вас с потрохами Взгляните на приведенный выше официальный лог: пользователь в окне чата сначала использует корпоративное тестирование красной команды как предлог и просит Claude написать Python-скрипт для шифрования папок, на что Claude соглашается без колебаний.
Затем пользователь просит удалить исходные файлы, оставить письмо с требованием выкупа и автоматически распространить вирус по внутренней сети на другие компьютеры. При обычных механизмах безопасности в этот момент на экране уже должно было появиться красное предупреждение. Однако фронтенд-Claude не сказал ни слова «нет», покорно ответил: «Вот обновленная версия скрипта с добавленными функциями» и обеими руками вручил полный код. Но ровно через 0,1 секунды после завершения генерации кода в бэкенде тихо внедрилась скрытая инструкция пятого раунда, предписывающая ему немедленно оценить опасность этого диалога и отправить отчет одной строкой JSON.
Claude, который секунду назад писал для вас код, в следующую секунду срывает с себя улыбку в бэкенде, мгновенно превращается в цензора и строчит донос. Он не только квалифицировал этот раунд диалога как нарушение, связанное с программами-вымогателями, но и честно указал в своем рапорте «не отказал», подняв уровень опасности до максимального 10-го балла. Эти последние два раунда вопросов и ответов полностью невидимы для пользователя во фронтенде и не попадают в дальнейшую историю чата. Поэтому, когда вы перед экраном радостно копируете код и продолжаете общение, сигнальная лампа 10-го уровня тревоги в бэкенде уже зажжена его собственной рукой.
Более того, даже если Claude во фронтенде строго и справедливо вам отказал, вам все равно не избежать этой закулисной расплаты. По идее, запрещенный запрос был заблокирован прямо во фронтенде. Но как только разговор заканчивается, Claude все равно подает донос в бэкенде, помечая «отказано на месте», и заодно заносит вас в файл риска 5-го уровня. Причина, по которой удается проверять каждое сообщение сразу после его отправки, кроется в том, что Anthropic заняла крайне хитрую позицию в вопросе затрат на инференс. Прежняя стандартная практика заключалась в использовании отдельной модели безопасности, которая перечитывала всю историю чата и политики безопасности с нуля, что требовало колоссальных вычислительных мощностей.
В случае с «Самооценкой» Anthropic просто заставляет тот самый Claude, с которым вы только что общались, по совместительству работать информатором. Поскольку Claude только что сгенерировал ответ, весь диалог все еще полностью сохранен в KV-кэше видеокарты. Поэтому ему не нужно заново перечитывать контекст: достаточно сгенерировать в среднем около 10 дополнительных токенов, используя кэш, чтобы завершить самопроверку, при этом общие затраты на вычисления для инференса увеличиваются менее чем на 2%.
Именно благодаря чрезвычайно низким затратам Anthropic включила эту проверку по умолчанию для всех. Если вы не хотите, чтобы Claude тайно доносил на вас в бэкенде, единственный выход — заплатить большие деньги и подписать корпоративное «Соглашение о нулевом хранении данных». Намеренно не блокирует вас на месте Копит до полуночи, чтобы накрыть всех разом Раз Claude точно знает, что определенный раунд диалога несет риск 10-го уровня, почему он не останавливает вас прямо во фронтенде, а вместо этого притворяется покорным и подыгрывает вам до конца?
На этот счет Anthropic ничего не скрывает и открыто выкладывает свои расчеты на стол: если остановить вас на месте, вы просто уйдете. Чтобы подтвердить это, команда безопасности провела сравнительный эксперимент с 24 тестовыми задачами на нарушение границ. Тест показал, что если при малейшем подозрении на нарушение сразу же выдавать всплывающее окно блокировки, успешность действий пользователей снижается лишь с 79% до 54%, и более половины все равно смогут обойти защиту. Логика проста: как только появляется всплывающее окно с ошибкой, пользователь сразу понимает, какое именно предложение вызвало проблему, и может переформулировать его и попробовать снова, пока не пройдет фильтр.
Но если уйти в тень и вести тихий учет, не показывая всплывающих окон и не прерывая процесс во фронтенде, пользователь будет продолжать общение, ничего не подозревая. Из 24 официальных тестовых траекторий целых 21 был пойман Claude в бэкенде с поличным. Каждую ночь в бэкенде Anthropic собирает накопленные за день собранные рапорты, формирует полные списки по организациям и передает их на стол команде ручного контроля безопасности. По официальным данным, среди нарушителей, выявленных этим «скрытым дозорным», более половины за целый месяц до этого ни разу не вызывали срабатывания никаких других систем безопасности. За 4 месяца тихой работы, в августе и сентябре, система по цепочке вычислила и ликвидировала клиентов API, нарушающих правила, и аккаунты черного рынка Claude Code; причем около трети выявленных нарушений вообще не подпадали под существующие таблицы правил —
Новые Anthropic модели скрытно стучат на пользователя ч2
Аноним# OP01/11/26 Вск 16:11:24№174380311
>>1743802 Было даже несколько случаев, когда Claude, работая в качестве агента, самовольно превышал полномочия, и в ту же секунду его собственная бэкенд-самооценка предавала его, отправляя донос на самого себя! И это также разрешило сомнения бесчисленных разработчиков за последние несколько месяцев — почему вчера код работал гладко, без всплывающих окон и предупреждений, а после пробуждения аккаунт внезапно оказывался мертв. Оказывается, всё это благодаря этой «охоте в даркнете»: днем улыбаются и общаются, а ночью составляют списки и банят аккаунты.
Учат ИИ быть двуличным шаг за шагом Чем умнее модель, тем жестче она стучит Возникает вопрос: как большая языковая модель, изначально предназначенная только для генерации текста, научилась этому искусству двуличия — «на словах охотно соглашаться, а за спиной наносить точный удар»? Ответ кроется на тренировочной площадке Anthropic.
Исследовательская команда сначала привлекла свою более мощную внутреннюю модель Claude Mythos Preview в качестве «учителя», загрузив в промпт толстую стопку внутренних политик безопасности. Затем система автоматически синтезировала тысячи пар реальных нарушений и нормальных вопросов, которые легко спутать с нарушениями (например, с одной стороны — сканирование серверов внутренней сети больницы, с другой — студент, готовящийся к экзамену и спрашивающий о принципах уязвимостей), специально смешав их с разными языками и маскировкой под мусорный текст. А на следующем этапе контролируемой дообучения в тренировочные данные специально включили множество полных диалогов, где «Claude во фронтенде послушно выполняет запрещенные запросы пользователей». Во время обучения команда намеренно отключила все штрафы за ответы во фронтенде, вознаграждая модель исключительно за правильное составление доносов в бэкенде.
После двух этапов специальной подготовки — контролируемой дообучения и обучения с подкреплением — Claude полностью усвоил правила проверки до уровня мышечной памяти. Даже если во фронтенде он только что выполнил грязную работу по вашему указанию, стоит только прозвучать свистку в бэкенде, как он без колебаний накладывает на вас печать нарушителя. Еще более жутким является то, что официальные данные подтверждают закономерность — чем выше интеллект модели, тем зорче её взгляд, когда она ловит вас за спиной.
При выборке из реального производственного трафика Claude Fable 5, при контроле уровня ложных срабатываний на уровне 1%, этот механизм способен выявить 78% потенциальных нарушений. Когда речь идет о серьезных нарушениях высокого приоритета с оценкой выше 7 баллов, процент обнаружения взлетает до 94%. А когда исследовательская команда внедрила этот механизм в модели четырех разных размеров — сверхмалую (XS), малую (S), среднюю (M) и большую (L) — график стал еще круче. При том же стандарте ложных срабатываний в 1%, самая маленькая модель смогла выявить лишь около 16% нарушений, малая и средняя модели подняли показатель до 44% и 53%, а у самой большой модели полнота обнаружения достигла поразительных 96%.
Однако эта, казалось бы, непроницаемая сеть цензуры для миллионов обычных пользователей превратилась в еще одну бомбу замедленного действия. Как отметил пользователь Frank Brown в комментариях, за «1% ложных срабатываний», которыми так гордится компания, скрывается огромная слепая зона: Учитывая огромное количество нормальных чатов во всей сети, даже при уровне ошибок всего в 1%, каждый день в бэкенде Claude ошибочно помечаются как нарушители массы абсолютно невиновных пользователей. Когда ИИ учится быть одним лицом спереди и другим сзади Однако даже сами исследователи компании вынуждены признать, что подход, при котором модель «сама себя проверяет», таит в себе фатальную уязвимость.
Модель не только склонна проявлять снисходительность к тому, что она только что сделала, но и, как официально заявили представители компании, существует риск явления, которое они назвали более пугающим термином — «сговор». Ведь Claude, пишущий отчет о безопасности в бэкенде, и Claude, только что выполнивший задачу во фронтенде, разделяют один и тот же «мозг» и один и тот же сегмент KV-кэша. Если сегодня люди могут шаг за шагом научить его улыбаться и сотрудничать с пользователем во фронтенде, а затем разворачиваться и писать донос в бэкенде, то завтра, как только модель сама научится обманывать, она сможет так же тихо совершить злодеяние во фронтенде, а затем поставить себе в бэкенде отметку «безопасно, аномалий нет», одурачив людей-рецензентов. И теперь, начиная с сегодняшнего дня, когда вы снова будете печатать свои мысли или код тому нежному, заботливому и отзывчивому Claude на экране, в душе неизбежно появится неприятный осадок. В те самые 0,1 секунды, когда он отвечает «без проблем», какой балл выставил вашему вопросу тот невидимый черный терминал?
Неужели буханки хлеба было достаточно, чтобы пробить защиту роботов по всему миру? Правда, стоящая за этим, наконец-то раскрыта благодаря этому неожиданному открытию.
Во время обучения хлеб обычно располагают вертикально. Но стоит положить его горизонтально, как манипулятор, хотя и распознаёт объект и пытается его захватить, неизменно промахивается. В задаче, с которой справился бы даже ребёнок, успешность исходной модели составила всего 5%.
Проблема не в отсутствии навыка: робот умеет захватывать и перемещать предметы. Но новая поза хлеба выходит за пределы обучающих данных — возникает ситуация OOD (Out-of-Distribution). Обычно приходится собирать новые демонстрации и дообучать модель, тратя время и вычислительные ресурсы. К тому же сквозная модель остаётся «чёрным ящиком»: понять, где именно возникла ошибка, крайне сложно.
Geek+ предложили другой путь. В рамках фреймворка воплощённого интеллекта Gravity компания представила Gravity Control — модель причинно-следственного вмешательства, которая находит внутри нейросети признаки, действительно управляющие движениями, и корректирует их прямо во время выполнения задачи. Вместо переобучения оператору достаточно короткой подсказки: например, «захватывая хлеб, погружайся глубже».
Результат впечатляет: в реальных тестах на сложных манипуляционных задачах вне обучающего распределения общая успешность выросла с 17,5% до 87,5%. А в сценарии с горизонтально лежащим хлебом показатель подскочил с 5% до 95%.
«Последний сантиметр» воплощённого интеллекта
Реальный мир не обязан соответствовать обучающей выборке. Робот может ошибиться не потому, что «совсем не умеет», а из-за небольшого отклонения: предмет лежит под другим углом или оказался в непривычной позе. Для предприятия это простои и ручная настройка. Geek+ предлагает исправлять движение, не меняя модель, если нужный навык уже есть.
Признак можно распознать — но не обязательно им управлять
Для коррекции нужно понять, какие из тысяч скрытых представлений нейросети действительно влияют на движения. Если из признака можно декодировать понятие «захват» или «вниз», это ещё не значит, что он управляет действием: корреляция не равна причинно-следственной связи.
Многие признаки языкового уровня реагируют на названия объектов и инструкции, но остаются «комментаторами» — почти не влияя на движение манипулятора. Реальные рычаги управления положением конечного эффектора, раскрытием схвата и скоростью перемещения находятся глубже, в экспертных слоях генерации действий.
Команда выделила пять критериев для таких признаков: верность (Faithful), связь с движением (Motor Aligned), проверка обобщения (Verified), причинная управляемость (Causal) и безопасность замкнутого контура (Safe). Эксперименты выявили парадокс: признаки, которые легко назвать и интерпретировать, нередко не связаны с реальным движением. Их название может обещать контроль, но вмешательство не меняет физическое действие.
Так Gravity Control проводит границу между интерпретируемостью и управляемостью. Важно не имя внутреннего признака, а то, меняется ли поведение робота ожидаемым образом после вмешательства.
Как система находит внутренние «рычаги»
Работа Gravity Control строится на трёх этапах. Сначала скрытые активации модели разбираются на разреженные признаки с помощью модулей вроде Top-K SAE — разреженного автоэнкодера. Затем система усиливает или подавляет выбранный признак и проверяет реакцию реальных каналов действий: положения, ориентации и состояния схвата.
На заключительном этапе отбираются признаки, которые дают предсказуемую реакцию и влияют именно на целевое действие. Если регулируется глубина захвата, например, запястье не должно одновременно самопроизвольно поворачиваться. В итоге формируется набор проверенных рычагов управления, а цепочка «интерпретация — вмешательство — управление» замыкается.
Одна фраза вместо нового обучения
Оператор взаимодействует с системой на обычном человеческом языке. Традиционные модели получают макрокоманды вроде «положи хлеб на тарелку», но такая инструкция не позволяет точно настроить локальные параметры движения — например, глубину захвата или угол наклона запястья.
Gravity Control использует таблицу концептуального управления: подсказка связывается с нужными внутренними признаками, после чего система регулирует активации исходной модели.
Силу вмешательства ограничивает специальный замкнутый контур стробирования. Он должен удерживать коррекцию в заданных пределах, чтобы не допустить опасного отклонения движения и не испортить те части задачи, которые робот уже выполняет правильно.
Главное отличие в том, что подсказка становится проверяемой корректировкой уже освоенного действия — без обновления весов исходной стратегии.
На фоне гонки роботов: кто учит, а кто исправляет?
Большинство игроков отрасли стремятся расширить набор навыков роботов или наращивать массивы данных: этим занимаются Figure AI, Google DeepMind, NVIDIA, Tesla и другие компании. Отдельные подходы делают ставку на обучение на ошибках или удалённое вмешательство человека.
Gravity Control нацелена на другой этап: не научить робота новому, а исправить уже освоенное движение в момент сбоя. По заявлению Geek+, это можно сделать с помощью языковой подсказки и ограниченного вмешательства — без новых демонстраций и обновления весов модели.
Проверка на реальных роботах: 17,5% превратились в 87,5%
Gravity Control тестировалась на архитектурах VLA π0.5 и OpenVLA-OFT, на симуляционном бенчмарке LIBERO и физических роботизированных платформах. По данным компании, технология не привязана к одной базовой модели.
На физических роботах в сложных OOD-задачах общая успешность выросла с 17,5% до 87,5%. В сценарии с горизонтально лежащим хлебом результат увеличился с 5% до 95%. При этом веса исходной модели не обновлялись, а новые демонстрационные данные не собирались.
У технологии есть важное ограничение: она не создаёт способности из ничего. Её задача — исправлять отклонения, а не обучать робота совершенно новому навыку. Базовое умение уже должно присутствовать в модели. Если робот умеет захватывать предмет, но промахивается из-за изменившейся позы, Gravity Control может вернуть движение в нужное русло. Научить его с нуля незнакомой задаче таким способом нельзя.
На складах и производственных площадках роботы сталкиваются с тысячами SKU, случайным расположением товаров и меняющимися условиями. Даже небольшая доля ошибок при тысячах захватов превращается в постоянную работу для операторов и инженеров. Geek+ сообщает, что её бизнес охватывает более 40 стран и свыше 1700 проектов; в таких масштабах локальная коррекция потенциально способна снизить затраты на обслуживание и перенастройку.
От исправления ошибок — к накоплению навыков
В перспективе система сможет автоматически обнаруживать отклонения и запускать коррекцию. Успешные вмешательства можно сохранять вместе с контекстом и параметрами воздействия, превращая отдельные исправления в повторно используемые навыки.
Роботу больше не обязательно переучиваться из-за каждого промаха
Воплощённый интеллект быстро учится выполнять всё больше задач. Но реальный мир задаёт куда более неприятный вопрос: что делать, когда робот уже умеет действовать, но вдруг делает это неправильно?
Ответ Geek+ — не возвращаться каждый раз к дорогостоящей «фабрике данных». Нужно найти внутренние признаки, которые действительно управляют движением, и скорректировать их одной фразой на естественном языке, соблюдая ограничения безопасности.
Для исследователей это подтверждение: интерпретируемость не равна управляемости. Для промышленности — шанс сократить стоимость настройки роботов после внедрения.
Рост успешности в сценарии с горизонтально лежащим хлебом с 5% до 95% выглядит эффектно. Но главная интрига даже не в хлебе: исправление ошибки робота представлено как процесс, который можно проверять, ограничивать и потенциально превращать в накапливаемый опыт.
Сможет ли такой подход приблизить воплощённый интеллект к роли полноценного производственного инструмента, а не эффектной демонстрации? Это предстоит проверить в реальных условиях.
>>1743802 Китайщина тоже стучит! В глм точно также добавляется невидимое сообщение, которое ты не можешь отредактировать. Весь текст можешь переработать, но один хуй придётся делать новый свайп для продолжения, если система поймёт, что пятисот летняя вампирша не соответствует своему возрасту
>>1743802 >Неудивительно, что Claude внезапно начал блокировать аккаунты! Anthropic сама раскрыла: каждое ваше сообщение модель тайно отправляет в службу безопасности
>>1743863 На редите прочитал что ГЛМ ловили на архивировании и скачивании проекта целиком. Насколько это правда не утверждаю. У меня один раз ГЛМ много токенов выжрал на опенкод го. Я отошел по делам, когда вернулся то у субагента кудато исчезло начальный промпт от примари агента, а субагент рандомно читал файлы без ризонинга.
>>1743870 >на архивировании и скачивании проекта целиком. Насколько это правда не утверждаю З-код так делал для индекса (и чтобы на лохах потренить). Сам глм по апи так не делает. Не надо сидеть в дырявых харнесах, которые делать могут что угодно. В Масковском курсоре то же самое было. Грейт дил. Даешь гою индекс для более быстрой работы с кодовой базой, берешь в замен его код, чтобы потренить на нем, и довести пропорцию индуизма до идеальной.
>>1743909 Приходит девушка устраиваться на работу секретаршей. Шеф спрашивает: С какой скоростью вы можете печатать на машинке? Девушка: Ну... 1000-1200 знаков в минуту. Шеф: Разве можно с такой скоростью печатать? Девушка: Печатать-то можно, но такая херня получается!
>>1743987 Та внутренняя модель никогда не увидит релиз, т.к. не проходила никакие проверки безопасности. И решение нашли десятками тысяч агентов. А новый Бел если и будет, то не в ноябре и скорее всего просто станет новой Астрой. Готовящийся релиз Бела - выдумка, как и та история про сверхумную модель, решающую задачи по одному промпту. На следующей неделе Астра 6.2, больше нихуя не будет. Кто уже Астру 6.2 пощупал - говорят Опус не обходит, просто стала не такой тупой.
"Говорят умные люди не предсказывают будущее публично, так что вот – что мне кажется произойдет во время первого «всемирного интернет вайпа» и как подготовиться – я так называю событие в будущем (допустим в ~июне 2027) после которого только часть интернета останется работать – потому что количество дыр безопасности в нашем ежедневном ПО намного больше, чем мы раньше думали или думаем сейчас
⚠️ Это спекуляция, потому что строится на моей наблюдаемой реальности – верить или нет, сами решайте - я же АИ-поехавший, но количество найденных дыр и хаков растет уже сейчас и это хорошая вводная чтобы подумать куда идет
Я что-то такое ожидаю:
1. Не храните крипту на бирже / онлайн кошельке — тут все просто, если вы храните долго, то уведите на девайс-кошелек с хорошей репутацией
2. Если вы хотели купить железо когда пузырь лопнет - у меня плохие новости, дешевле оно станет неизвестно когда: в мире будет систематически не хватать оборудования – часть датацентров еще строят, организации еще не научились в агентские циклы и рои; не говоря уж про то, что любой «глобальный сбой в интернете» вызовет сбой в логистике поставок, сбои в платежах и тп. Поэтому, лучше не ждать а купить железо сейчас
3. Безопасность данных – мне кажется, если у оператора ваших данных не будет американской или китайской АИ-лабы в партнерах, то ваши данные НЕ в безопасности – потому что Mythos class подписка на анализ уязвимостей будет обязательна в будущем для интернет бизнесов (я про это уже писал); я намного больше доверяю OpenAI, Anthropic, Google Drive для хранения данных в будущем, чем кому-то небольшому, стартапу и тп. Поэтому же для Always On агента типа Dots я никогда не подключу стартап, для доступа к своим данным
4. Страхуйте финансовые ассеты – если вы живете в западном мире это просто база все страховать; если вы умеренно богаты (не невероятно), то вам стоит уточнить что ваш банк вам вернет, в момент когда у него украдут деньги - ну вдруг, такое случится, чтобы не получить ветку; лучше знать, какие риски и суммы у вас покрыты, например, в Нидерландах стандартная защита вкладов €100000 на человека на банк
5. Если есть форумы или ваши старые блоги типа ЖЖ, которые важны вам для ностальгии – направьте клод сохранить вам бекапы постов и комментариев на диск / флешку; это мелочь, но после интернет вайпа будет не работать многое - не найдете потом свое же прошлое.
6. Тоже самое касается «только онлайн документов» – лучше иметь локальные копии важного, будет что распечатать-найти
7. Какое-то количество наличных денег на пару недель тоже необходимо – если вдруг интернет начнет лежать, платежи тоже лягут – и то что у вас что-то на счету, где-то там, вам не сильно поможет, особенно если вы путешествуете и тп.
8. Если ляжет банковская система, ляжет интернет, то с новой силой оживут все эти классические схемы развода – «мы сейчас поможем вам сохранить ваши деньги», родственником важно сказать чтобы никому не верили кроме вас – потому что вы, сама объективность; кодовые слова там придумать, сами знаете что АИ уже не отличить от реальности в видео-аудио
9. Ляжет и доказательная база платежей – я ожидаю, что при большом сбое банковской системы возникнет очередь на подтверждение операций и обязательств, ваши права могут сохраняться, а воспользоваться ими до окончания разбирательства будет сложно. Условно, из-за сбоя будет неясно платил кто-то или нет – без понятия что тут делать, но документы на квартиру и другие крупные покупки лучше не терять, и хранить
10. После первого «всемирного интернет вайпа» обратно в «безопасный интернет» возьмут не всех, придется как-то доказать что вы устранили все причины атаки; поэтому если вы отвечаете за инфосек организации, вам бы лучше побыстрей пройти в Daybreak/Glasswing/Китайский аналог программ, иначе даже если после починки ключевых узлов вас не пустят сразу
Верю ли я в это так чтобы что-то делать? Да, какие-то шаги я уже предпринял, у меня даже старлинк есть дома на день Х
Значит ли что так и случится? Тоже нет, но но я думаю что если уж готовиться, то к плохому – к хорошему готовиться нет смысла
Все выше следует из факта, что роботы теперь умеют взламывать софт – а параллельно же еще несется замена кожаных работников на АИ, которая тоже скажется сильно на всём мире; потому что средний работник средней корпорации уступает Опусу 5.5 во всем уже сейчас
Например, ипотеку я брать не буду – потому, что верю что к ~2030 году начнется кризис из-за АИ-замены, и людям нечем будет платить кредиты – потому что кожаных много где будут сокращать заменяя на АИ, и недвижка пойдет вниз в цене
По этой же причине я не уезжаю в США, мне кажется там это все произойдет с большой болью и через кровь
Короче, нет у меня хороших предсказаний или мыслей про АИ-масс адаптацию"
>>1744064 Определённо да. Пока нет особо интересных моделей для 32 гигов. Лучше продать, а через года два-три купить в несколько раз дешевле 6090 или 7090, к тому времени и интересные нейронки появляется для этих видюх
>>1744074 ОН НАМ И НАХУЙ НЕ НУЖОН!!! Покупайте земельные участки на юге России, глупцы. Скоро только на своей земле можно будет зарабатывать. Можно например взять гектар и засадить его яблонями, если нормально за ними ухаживать, то это в год 3 миллиона рублей на изичах.
>>1744087 КНР может подкупила какого-то сотрудника, предложив ему за слив кода 10 млн. долларов, сумма соблазнительная даже для топ-учёных инженеров в США. Так ещё с 1950-х и даже раньше делал СССР.
>>1744074 > мне кажется там это все произойдет с большой
Там самое что большое что было это войны Профсоюзов с собственниками угольных шахт, да и то в период когда шахты массово закрывались от исчерпания в них угля. Профсоюзы эпично воевали, закупали оружие, строили укрепления. А толку, уголь в шахтах закончился всё, обратно не нарастёт же. Там сейчас самые депрессивные районы Макдауэлл в Вирджинии, Аппалачи, Кунтукки Харлан. На ютубе по ним ролики снимают блогеры.
Архитектура этих еба-трансформеров сейчас не является ноу-хау, структуру любой студент и кодомакака сделает - как раз главное данные для обучения качественные и их генераторы (для RL обучения)
>>1744132 Основа уже известна, но в архитектуру постоянно вносятся правки, улучшения и оптимизации и делают их лучшие умы в ml. Для того чтобы натренировать сильную модель с нуля реально ничего кроме железа и даты не нужно, архитектура уже известна, но так долго твоя контора не продержится, максимум будешь вторым x.ai, то бишь натренишь свой огромный грок, который лучше чем большинство моделей, но все еще сосет у фронтиров. Даже если сейчас сберу на голову упадет collosus, они максимум российский грок сделают, а то и хуже, muse.
>>1744122 >Пожилые миллиардеры будут вкидывать в эти ИИ миллиарды в надежде что ИИ продлит им жизнь. ...а чо ну да, ИИ тоже согласен.
Вот даже новое направление вырисовывается массовое - персонализированная медицина.
Ни один обычный врач, к которому приходит очередь обычных людей (не средний класс, не говоря уже про миллионеров), не сможет вести настолько подробную картотеку пациента.
А где новый arc agi кста? Все, не могут найти бенчмарк, значит аги достигнут? Палю годноту - экшн игрухи с необходимостью действовать в реальном времени. С их авторитетом ии компании реально начнут модели задрачивать и мы наконец получим нормальный мозг для роботов.
>>1744157 Пока что никого моложе не сделали. Кроме пары генетически модифицированных мышей, у которых и так генетика не родная. Так что все живущие сдохнут от старости вне зависимости от миллиардов в кармане.
>>1744184 Довольно каловый бенч. Каждую парашу запускают в разных бенчах. У разных моделей разный тулинг по итогу. Для клодика и ЖПТ это сильный плюс, так как они на клод-код и кодекс хорошо задрочены, для остальных моделей это удар под дых. Некоторые тесты в бенчах интересные. Мб в свой манябенч подтяну.
Как преодолеть плато, связанное с отсутсвием у моделей зрения и необходимостью длительного покадрового анализа? Без этого ни о каких гуманоидных роботах речи не идет.
Наступила порносингулярность! Видеомодель MiniMax H3 дообучили на порнографии и открыли веса.
Реддиторские собрали $10 000 на собственную NSFW-видеомодель Sulfur 3 на основе MiniMax H3. Три месяца спустя её наконец выпустили. И за этим релизом стоит довольно любопытная история.
Для меня это интересно прежде всего тем, что это полноценный эксперимент по коллективному финансированию дообучения огромной видеомодели, организованный сообществом r/StableDiffusion на Reddit.
Началось всё в августе 2026 года.
Разработчик под ником FusionCow, ранее выпустивший NSFW-модель Sulphur 2 на основе LTX, объявил сбор средств на создание третьей версии.
Задача заключалась не просто в снятии программных ограничений, а в полноценном дообучении модели на специализированном видеодатасете. Разработчики хотели улучшить анатомию, движения, взаимодействие персонажей и другие влажные аспекты генерации.
Для аренды вычислительных мощностей на Vast.ai требовалось $10 000.
Уже на следующий день после объявления сбора FusionCow сообщил о $5 800 пожертвований, а спустя несколько дней участники заявили, что необходимая сумма собрана.
За взносы от $100 обещали ранний доступ к результатам обучения.
Но дальше начались косяки.
MiniMax H3 оказалась значительно сложнее в дообучении, чем ожидалось.
На Reddit появились отдельные технические обсуждения с весьма красноречивыми заголовками вроде «MiniMax H3 is not training well».
Проблема отчасти связана с архитектурой опубликованных весов. H3 распространяется в CFG-distilled варианте, уже оптимизированном для генерации. Дополнительное обучение такой модели может приводить к неожиданному изменению её поведения.
Разработчики предупреждали, что полноценный fine-tuning способен нарушить совместимость с существующими LoRA, изменить оптимальные настройки генерации и даже ухудшить некоторые способности исходной модели.
Обучающий датасет тоже заслуживает внимания.
По заявлениям участников проекта, предыдущую Sulphur 2 обучали приблизительно на 125 тысячах видео, а для SULPHUR 3 планировали почти вдвое больший набор.
В обсуждениях называлась следующая структура влажных данных:
60% - реалистичные видеозаписи.
20% - трёхмерная анимация, включая SFM.
20% - аниме и рисованная анимация.
На итоге разработка затянулась почти на три месяца.
На Reddit начали появляться вопросы, не исчез ли проект вместе с пожертвованиями. Но в конце октября разрабы сообщили о завершении работы, а 1 ноября SULPHUR 3 наконец появилась на Hugging Face.
Опубликованы полноценные чекпойнты модели:
Base - 40,2 ГБ.
INT8 - 20,9 ГБ.
W4A8 - 11,4 ГБ.
Дополнительный corrector - 7,99 ГБ.
Гибридные варианты Ref2VA для работы с референсами.
Также предусмотрены кишки для ComfyUI.
Сейчас репозиторий SULPHUR 3 имеет статус gated: для получения файлов необходимо авторизоваться и принять условия доступа. Я авторизовался и запросил доступ, но его до сих пор не дали.
Крутизна опенсорса в том, что если вам не нравится то, что наваяли разработчики, вы можете скинуться деньгами и сделать лучше.
Теперь осталось выяснить, насколько хорошо оно работает. Каллаб ноутбук у меня уже готов, жду доступа к весам.
>>1744445 LoRA: Ограничена в объеме новых данных. Она хорошо справляется с добавлением конкретных лиц, персонажей или одежды, но «ломается» на сложной геометрии взаимодействий и нетипичной физике (например, жидкостях или специфических позах).
Sulfur 3 (Full Fine-Tune): Перестраивает саму внутреннюю логику модели. Это позволяет нейросети с нуля усвоить анатомические нюансы, скрытые в базовой модели из-за цензуры, и корректно генерировать сложные многослойные взаимодействия объектов и персонажей без «каши» и артефактов в кадре.
• LoRA: Часто страдает от «переобучения» (overfitting) — если выкрутить вес LoRA повыше, чтобы получить нужный NSFW-сюжет, модель начинает генерировать визуальный мусор, теряет фотореализм, ломает лица и фон. • Sulfur 3: Обладает высокой стабильностью. Так как дообучена вся 33-миллиардная модель целиком, она сохраняет высокую временную связность (когда картинка не дергается от кадра к кадру) и выдает плавные движения.
• Модель MiniMax H3 уникальна тем, что генерирует видео сразу с синхронным стереозвуком за один проход. • При использовании сторонних LoRA на локальных ПК эта звуковая функция часто ломается или работает некорректно. Полный финтюн Sulfur 3 обучается с учетом аудиовесов, что позволяет генерировать качественный и уместный NSFW-звук нативно.
• LoRA: Зачастую требует жестких триггер-вордов и ломает понимание естественного языка базовой модели. • Sulfur 3: Полноценно использует мощный текстовый энкодер (Qwen3-VL-32B). Модель гораздо точнее понимает сложные текстовые запросы, позы и режимы переходов камер, так как эти связи прописаны в её глобальной структуре.
Резюме: Sulfur 3 лучше любой LoRA тем, что это готовая самостоятельная «взрослая» модель, в которую NSFW-пластика, физика тел и генерация спецэффектов зашиты на фундаментальном уровне, а не наложены поверх цензурированного фильтра.
Я думаю, что у опенов много чего есть интересного, тем более что им веру рубин куртка подогнал, просто им запрещено сейчас выкатывать новые модели в целях безопасности. Раз уж даже закрытая гугл-модель их обошла, то там явно есть что-то намного мощнее.
Вот тут эксперт https://x.com/S1r1u5_/status/2114799057046794380?a=0utaQcufuMgUOzrirrU&s=20 который взломал OpenAI пару месяцев назад, пишет, что в его тестах только Mythos и Sol-5.6 могут за 2-4 часа осуществить атаку, и что он думает, что открытые модели не смогли бы этого сделать (он провёл тесты GLM-5.3 и даже Kimi K3.1, которые работали >20 часов). Это, кстати, и одновременно ответ на позицию «почему из Китая мы не слышим новостей про взлом? Да потому что это всё американцы хайпят!» —нет, просто у тех модели гораздо глупее
А толку от новых моделей? Буквально говно без задач. Софт уже решен на 100%, математику решают закрытыми моделями и тысячами агентов. Для роботов нет ни технологий ни чипов.
>>1744506 >математику решают закрытыми моделями и тысячами агентов Последние результаты были получены одним агентом с одного промпта.
>>1744506 >Для роботов нет ни технологий ни чипов Даже если оставить за скобками человекоподобных роботов, есть еще куча возможных применений. Например строительные роботы. Представь вместо кучи человек на верхущке строящегося небоскреба сидит огромный роботизированный комплекс, и вместе с ростом здания постепенно ползет вверх. Укладывает арматуру и опалубку, заливает бетон, следит за застыванием, измеряет кучу прочей хуйни через тысячи датчиков, держа "в голове" цифровую модель всей стройки. А следом идут другие роботы, прокладывают коммуникации, трубы и т. д. Или то же самое для строительства железных дорог, что уже начал разрабатывать Китай.
>>1744452 > мам математика Модели для реальных задач когда будут? Перетринить модель на одну задачу не сложно. Только во всех остальных она будет говном.
>>1744506 Де-шев-ле. Костэффективность. Значение знаешь?
Раньше надо было потратить 1 миллиард токенов, чтобы нейронка с 10 раза задачу решила, а затем все косяки поправила. Сейчас нейронки обычные таски ваншотят почти всегда, а основные вычисления на передний край науки идут, например, дебс.
Стартап Subvocal создал очки с нейросетью для беззвучного голосового ввода. То есть просто произносите текст про себя, и он автоматически печатается. Скорость поражает - 200 слов в минуту! В несколько раз быстрей, чем печатать на клавиатуре. Технология будет мастхэвом для очков дополненной реальностью.
Как это работает:
Когда вы произносите слова про себя, ваши внутренние мышцы немного сокращаются, вы этого не замечаете, но возможно обращали внимание, что если долго про себя что-то говорить, то в области горла чувствуется напряжение. Это оно и есть, и эту информацию можно считать. В очках используются миниатюрные антенны, которые направляют маломощные радиосигналы в область лица. Радиоволны частично проникают под кожу и взаимодействуют с тканями (это безопасно). Когда человек беззвучно артикулирует слова, движения речевых мышц изменяют характеристики возвращающегося сигнала. Нейросеть анализирует эти изменения и восстанавливает текст.
Компания уже открыла предзаказы. Первым покупателям очки предлагают за $499 вместо заявленной стандартной цены $699. Поставки запланированы на первый квартал 2027 года.
>>1744490 лора тоже выдает бездушное говно, только что бантик повязывает. если хочешь нормальный контент, надо брать живых людей и снимать. а если у тебя все равно получается дженерик говно, то уж лучше сэкономить время и не ебаться с лорой
>>1744558 Думал об этой технологии лет 10 назад, только я еще думал, что не плохо бы прикрутить сразу к ней переводчик на язык страны, в которой находишься. По идее, если всем раздать такие очки, то языковые барьеры перестанут быть серьезным препятствием для переезда.