Пишу как неведомый в ИИ вам за советом. Использовал грок для создания NSFW контента, а именно генерация картинок и их анимация. Подскажите, есть ли аналоги для подобного функционала или же обход цензуры в грок
Сап, нейрач. Пару месяцев назад начал вайб кодить через claude code используя их десктоп приложение. Но постоянно бан прилетает на аккаунты. Аккаунты свои были, первые два бана покупал подписку через плати.сру, под конец месяца бан прилетал. В третий раз оплатил виртуальной картой, бан через неделю. Квн обмазался платным, подключался к одному серверу, но ip все равно менялся. Щас при покупке подписки уже верификацию просит. Пробежался по треду ai агентов и чувство, что у всех все классно. Есть те кто с банами сталкивался? Что помогло?
>>1670281 >Из-за массового сбора данных Anthropic и другие лаборатории начали внедрять жесткие проверки (вплоть до селфи и паспортов) для доступа к своим продвинутым API Сингулярность.
>>1669841 Имею в виду, когда берёшь конец (последний кадр) и делаешь продолжение. Главное чтобы персонажи не менялись между сценами (для этого можно применять рефы), и чтобы звук был консистентным без резкой смены. Старый грок говнил дизайны персонажей (форму лица и детали), хз как сейчас.
Я щитаю, что делать кино куда интереснее, чем картинки! Можно представить что делаешь трейлер или тизер для своей оригинальной видеоигры: графон, стилизация, эффекты, работа камеры, экшн, моушн, боевые мувы и спеллы, крутые дизайны, сценери, лор вымышленной вселенной, разные монстры и данжи, всё это под бодрую музычку. Хотет делать видосы по своему собственному Dark Souls.
>>1669521 (автор этого псто за 12 часов но этого сообщения порезал себе палец об консерву из-за кривой открывашки и попыток открыть недораскрывшуюся банку ножом)
Ребята,как думаете,сможет ли ии делать к концу 2030 годов такие картинки,что каждый сможет поверить?
Аноним01/08/26 Суб 20:38:13№1665986Ответ
>>1667488 Монитор по мне смотрится вполне правдоподобным, пусть даже чуть нелепые кнопки, но не сильно уходят от того, что бывало, больше по другим моментам претензии серьёзные, по столам, например.
>>1669870 Ну и в итоге только на первом пике 14", и у него на самом деле совсем не такая огромная рамка снизу на пикрел если также прямо смотреть. Остальные 15" и больше. Этот сгенеренный уродец еще и не 4:3, это вообще фиаско.
>>1670155 По мне мониторы выглядят правоподобно. К слову они смотрятся больше, чем на 14 дюймов, скорее на 17. Принципиальные косяки другие, то же отсутствие системных блоков. Косяки с мебелью, если пытаться понять, как там ножки выглядят и где у какого стола его ножки.
Смысл шизовый у картинки, почему так рандомно разбросаты столы, что за ними невозможно сидеть, даже к компам подобратья невозможно, при этом компьютеры включены. Один стол поверх другого, хотя модель одинаковая и высота должна быть одинаковая, но главное, что за бред сам по себе?
Если ты ставишь задачу придумать картинку, что от настоящей не отличишь, то тебе надо брать в качестве референса реальное оборудование, конкретные модели, реальную мебель. Должен быть какой-то смысл у картинки, а не каша из столов, как здесь.
Чем сейчас лучше переводить?
Аноним06/08/26 Чтв 23:40:05№1670054Ответ
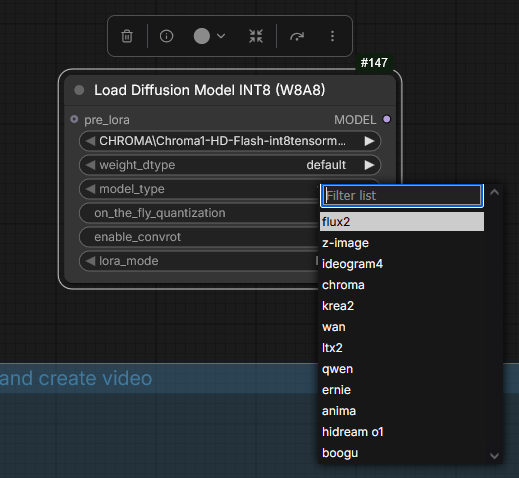
Терминология моделей prune — удаляем ненужные веса, уменьшаем размер distill — берем модель побольше, обучаем на ее результатах модель поменьше, итоговый размер меньше quant — уменьшаем точность весов, уменьшаем размер scale — квантуем чуть толще, чем обычный fp8, чтобы качество было чуть лучше, уменьшение чуть меньше, чем у обычного квантования, но качество лучше merge — смешиваем несколько моделей или лор в одну, как краски на палитре.
lightning/fast/turbo — а вот это уже просто название конкретных лор или моделей, которые обучены генерировать видео на малом количестве шагов, они от разных авторов и называться могут как угодно, хоть sonic, хоть sapogi skorohody, главное, что они позволяют не за 20 шагов генерить, а за 2-3-4-6-8.
Кейворды для дополнительных вещей: SVI, RuneXX, LTX Director.
В этом треде обсуждаем генерацию охуительных историй и просто общение с большими языковыми моделями (LLM). Всё локально, большие дяди больше не нужны!
Здесь мы делимся рецептами запуска, настроек и годных промтов, расширяем сознание контекст и бугуртим с кривейшего тормозного говна.
Тред для обладателей топовых карт NVidia с кучей VRAM или мажоров с проф. картами уровня A100, или любителей подождать, если есть оперативная память. Особо терпеливые могут использовать даже подкачку и запускать модели, квантованные до 8 5 4 3 2 0,58 бит, на кофеварке с подкачкой на микроволновку.
Дополнительные ссылки: • Перевод нейронками для таверны: https://rentry.co/magic-translation • Пресеты под локальный ролплей в различных форматах: http://web.archive.org/web/20250222044730/https://huggingface.co/Virt-io/SillyTavern-Presets • Шапка почившего треда PygmalionAI с некоторой интересной информацией: https://rentry.co/2ch-pygma-thread • Последний известный колаб для обладателей отсутствия любых возможностей запустить локально: https://colab.research.google.com/drive/11U-bC6AxdmMhd3PF9vWZpLdi6LdfnBQ8?usp=sharing • Инструкции для запуска базы при помощи Docker Compose: https://rentry.co/oddx5sgq https://rentry.co/7kp5avrk • Пошаговое мышление от тредовичка для таверны: https://github.com/cierru/st-stepped-thinking • Потрогать, как работают семплеры: https://artefact2.github.io/llm-sampling/ • Выгрузка избранных тензоров, позволяет ускорить генерацию при недостатке VRAM: https://www.reddit.com/r/LocalLLaMA/comments/1ki7tg7 • Инфа по запуску на MI50, тесты производительности и прочее: https://arkprojects.space/wiki/AMD_GFX906 • Тесты tensor_parallel: https://rentry.org/8cruvnyw
Архив тредов можно найти на архиваче: https://arhivach.vc/?tags=14780%2C14985
Шапка в https://rentry.co/llama-2ch, предложения принимаются в треде.
>>1665796 Да конечно стоят, ниче хардкорного но и всегда будет до чего докопаться, не в промпте так в карточке. Но тут как бы весь смысл в парадоксе, карточка должна быть для кума, а иначе и батю отыгрывать не интересно. Во всякую ваниль я еще со старой гпт наигрался
Агентов и вайб-кодинга тред #16 /agents/
Аноним29/07/26 Срд 21:39:28№1663511Ответ
Тред про AI-агентов - от вайб-кодинга до персональных ассистентов, которые сидят в твоих чатах, читают заметки и автономно ломают всё вокруг. Для кодеров, которые разучились писать руками, и для гуманитариев, чей диплом филолога наконец котируется в IT. Сеньор в 2026 - это тот, кто умеет внятно объяснить машине, чего он блять хочет.
С чего начать: • Хочешь кодить с AI эффективно: Cursor или Claude Code • Хочешь кодить в VS Code без привязки к конкретному провайдеру: Kilo Code, Cline или Roo Code + OpenRouter • Хочешь кодить с AI локально: OpenCode, Qwen Code или Pi Coding Agent + из моделей аноны советуют Qwen3.6, подробности в llama-треде • Хочешь приложение без кода: Lovable или bolt.new • Хочешь автоматизировать рутину: n8n или Langflow • Хочешь персонального ассистента: OpenClaw + API корпов или локальная модель на твоей пеке
Полезные тулзы: • RTK: https://github.com/rtk-ai/rtk - CLI-прокси, сжимает вывод консольных команд перед попаданием в контекст агента • Caveman: https://github.com/juliusbrussee/caveman - скилл с набором слэш-комманд, заставляет агента отвечать кратко • ast-grep: https://github.com/ast-grep/ast-grep - структурный поиск/замена по AST, экономит токены агента при рефакторинге • Hindsight: https://github.com/vectorize-io/hindsight - долговременная память для агентов: копит факты и помнит когда что было • fff: https://github.com/dmtrKovalenko/fff - быстрый файловый поиск/греп для агентов
Локалки и прочее API: • OpenRouter: https://openrouter.ai • NVIDIA Build: https://build.nvidia.com/models - бесплатно, 40 RPM, OAI-Like API, 100+ моделей включая DeepSeek/GLM/MiniMax • OpenCode Zen: https://opencode.ai/zen - кодинг-модели, есть временно-бесплатные (DeepSeek V4 Flash, MiMo) + pay-as-you-go без наценки • llama-тред: >>1663069 (OP)
Шаблон для переката: https://rentry.co/2ch-agents Предыдущий тред: >>1660441 (OP)
В этом треде обсуждаем генерацию охуительных историй и просто общение с большими языковыми моделями (LLM). Всё локально, большие дяди больше не нужны!
Здесь мы делимся рецептами запуска, настроек и годных промтов, расширяем сознание контекст и бугуртим с кривейшего тормозного говна.
Тред для обладателей топовых карт NVidia с кучей VRAM или мажоров с проф. картами уровня A100, или любителей подождать, если есть оперативная память. Особо терпеливые могут использовать даже подкачку и запускать модели, квантованные до 8 5 4 3 2 0,58 бит, на кофеварке с подкачкой на микроволновку.
Дополнительные ссылки: • Перевод нейронками для таверны: https://rentry.co/magic-translation • Пресеты под локальный ролплей в различных форматах: http://web.archive.org/web/20250222044730/https://huggingface.co/Virt-io/SillyTavern-Presets • Шапка почившего треда PygmalionAI с некоторой интересной информацией: https://rentry.co/2ch-pygma-thread • Последний известный колаб для обладателей отсутствия любых возможностей запустить локально: https://colab.research.google.com/drive/11U-bC6AxdmMhd3PF9vWZpLdi6LdfnBQ8?usp=sharing • Инструкции для запуска базы при помощи Docker Compose: https://rentry.co/oddx5sgq https://rentry.co/7kp5avrk • Пошаговое мышление от тредовичка для таверны: https://github.com/cierru/st-stepped-thinking • Потрогать, как работают семплеры: https://artefact2.github.io/llm-sampling/ • Выгрузка избранных тензоров, позволяет ускорить генерацию при недостатке VRAM: https://www.reddit.com/r/LocalLLaMA/comments/1ki7tg7 • Инфа по запуску на MI50, тесты производительности и прочее: https://arkprojects.space/wiki/AMD_GFX906 • Тесты tensor_parallel: https://rentry.org/8cruvnyw
Архив тредов можно найти на архиваче: https://arhivach.vc/?tags=14780%2C14985
Шапка в https://rentry.co/llama-2ch, предложения принимаются в треде.
Тред про AI-агентов - от вайб-кодинга до персональных ассистентов, которые сидят в твоих чатах, читают заметки и автономно ломают всё вокруг. Для кодеров, которые разучились писать руками, и для гуманитариев, чей диплом филолога наконец котируется в IT. Сеньор в 2026 - это тот, кто умеет внятно объяснить машине, чего он блять хочет.
С чего начать: • Хочешь кодить с AI эффективно: Cursor или Claude Code • Хочешь кодить в VS Code без привязки к конкретному провайдеру: Kilo Code, Cline или Roo Code + OpenRouter • Хочешь кодить с AI локально: OpenCode, Qwen Code или Pi Coding Agent + из моделей аноны советуют Qwen3.6, подробности в llama-треде • Хочешь приложение без кода: Lovable или bolt.new • Хочешь автоматизировать рутину: n8n или Langflow • Хочешь персонального ассистента: OpenClaw + API корпов или локальная модель на твоей пеке
В этом треде обсуждаем генерацию охуительных историй и просто общение с большими языковыми моделями (LLM). Всё локально, большие дяди больше не нужны!
Здесь мы делимся рецептами запуска, настроек и годных промтов, расширяем сознание контекст и бугуртим с кривейшего тормозного говна.
Тред для обладателей топовых карт NVidia с кучей VRAM или мажоров с проф. картами уровня A100, или любителей подождать, если есть оперативная память. Особо терпеливые могут использовать даже подкачку и запускать модели, квантованные до 8 5 4 3 2 0,58 бит, на кофеварке с подкачкой на микроволновку.
Дополнительные ссылки: • Перевод нейронками для таверны: https://rentry.co/magic-translation • Пресеты под локальный ролплей в различных форматах: http://web.archive.org/web/20250222044730/https://huggingface.co/Virt-io/SillyTavern-Presets • Шапка почившего треда PygmalionAI с некоторой интересной информацией: https://rentry.co/2ch-pygma-thread • Последний известный колаб для обладателей отсутствия любых возможностей запустить локально: https://colab.research.google.com/drive/11U-bC6AxdmMhd3PF9vWZpLdi6LdfnBQ8?usp=sharing • Инструкции для запуска базы при помощи Docker Compose: https://rentry.co/oddx5sgq https://rentry.co/7kp5avrk • Пошаговое мышление от тредовичка для таверны: https://github.com/cierru/st-stepped-thinking • Потрогать, как работают семплеры: https://artefact2.github.io/llm-sampling/ • Выгрузка избранных тензоров, позволяет ускорить генерацию при недостатке VRAM: https://www.reddit.com/r/LocalLLaMA/comments/1ki7tg7 • Инфа по запуску на MI50, тесты производительности и прочее: https://arkprojects.space/wiki/AMD_GFX906 • Тесты tensor_parallel: https://rentry.org/8cruvnyw
Архив тредов можно найти на архиваче: https://arhivach.vc/?tags=14780%2C14985
Шапка в https://rentry.co/llama-2ch, предложения принимаются в треде.
>>1663070 В целом здравая идея, но модели все равно по-разному инструкции слушают. Могут по итогу быть расхождения, хотя крупные изменения так реально эффективнее проверять.
Тред про AI-агентов - от вайб-кодинга до персональных ассистентов, которые сидят в твоих чатах, читают заметки и автономно ломают всё вокруг. Для кодеров, которые разучились писать руками, и для гуманитариев, чей диплом филолога наконец котируется в IT. Сеньор в 2026 - это тот, кто умеет внятно объяснить машине, чего он блять хочет.
С чего начать: • Хочешь кодить с AI эффективно: Cursor или Claude Code • Хочешь кодить в VS Code без привязки к конкретному провайдеру: Kilo Code, Cline или Roo Code + OpenRouter • Хочешь кодить с AI локально: OpenCode, Qwen Code или Pi Coding Agent + из моделей аноны советуют Qwen3.6, подробности в llama-треде • Хочешь приложение без кода: Lovable или bolt.new • Хочешь автоматизировать рутину: n8n или Langflow • Хочешь персонального ассистента: OpenClaw + API корпов или локальная модель на твоей пеке
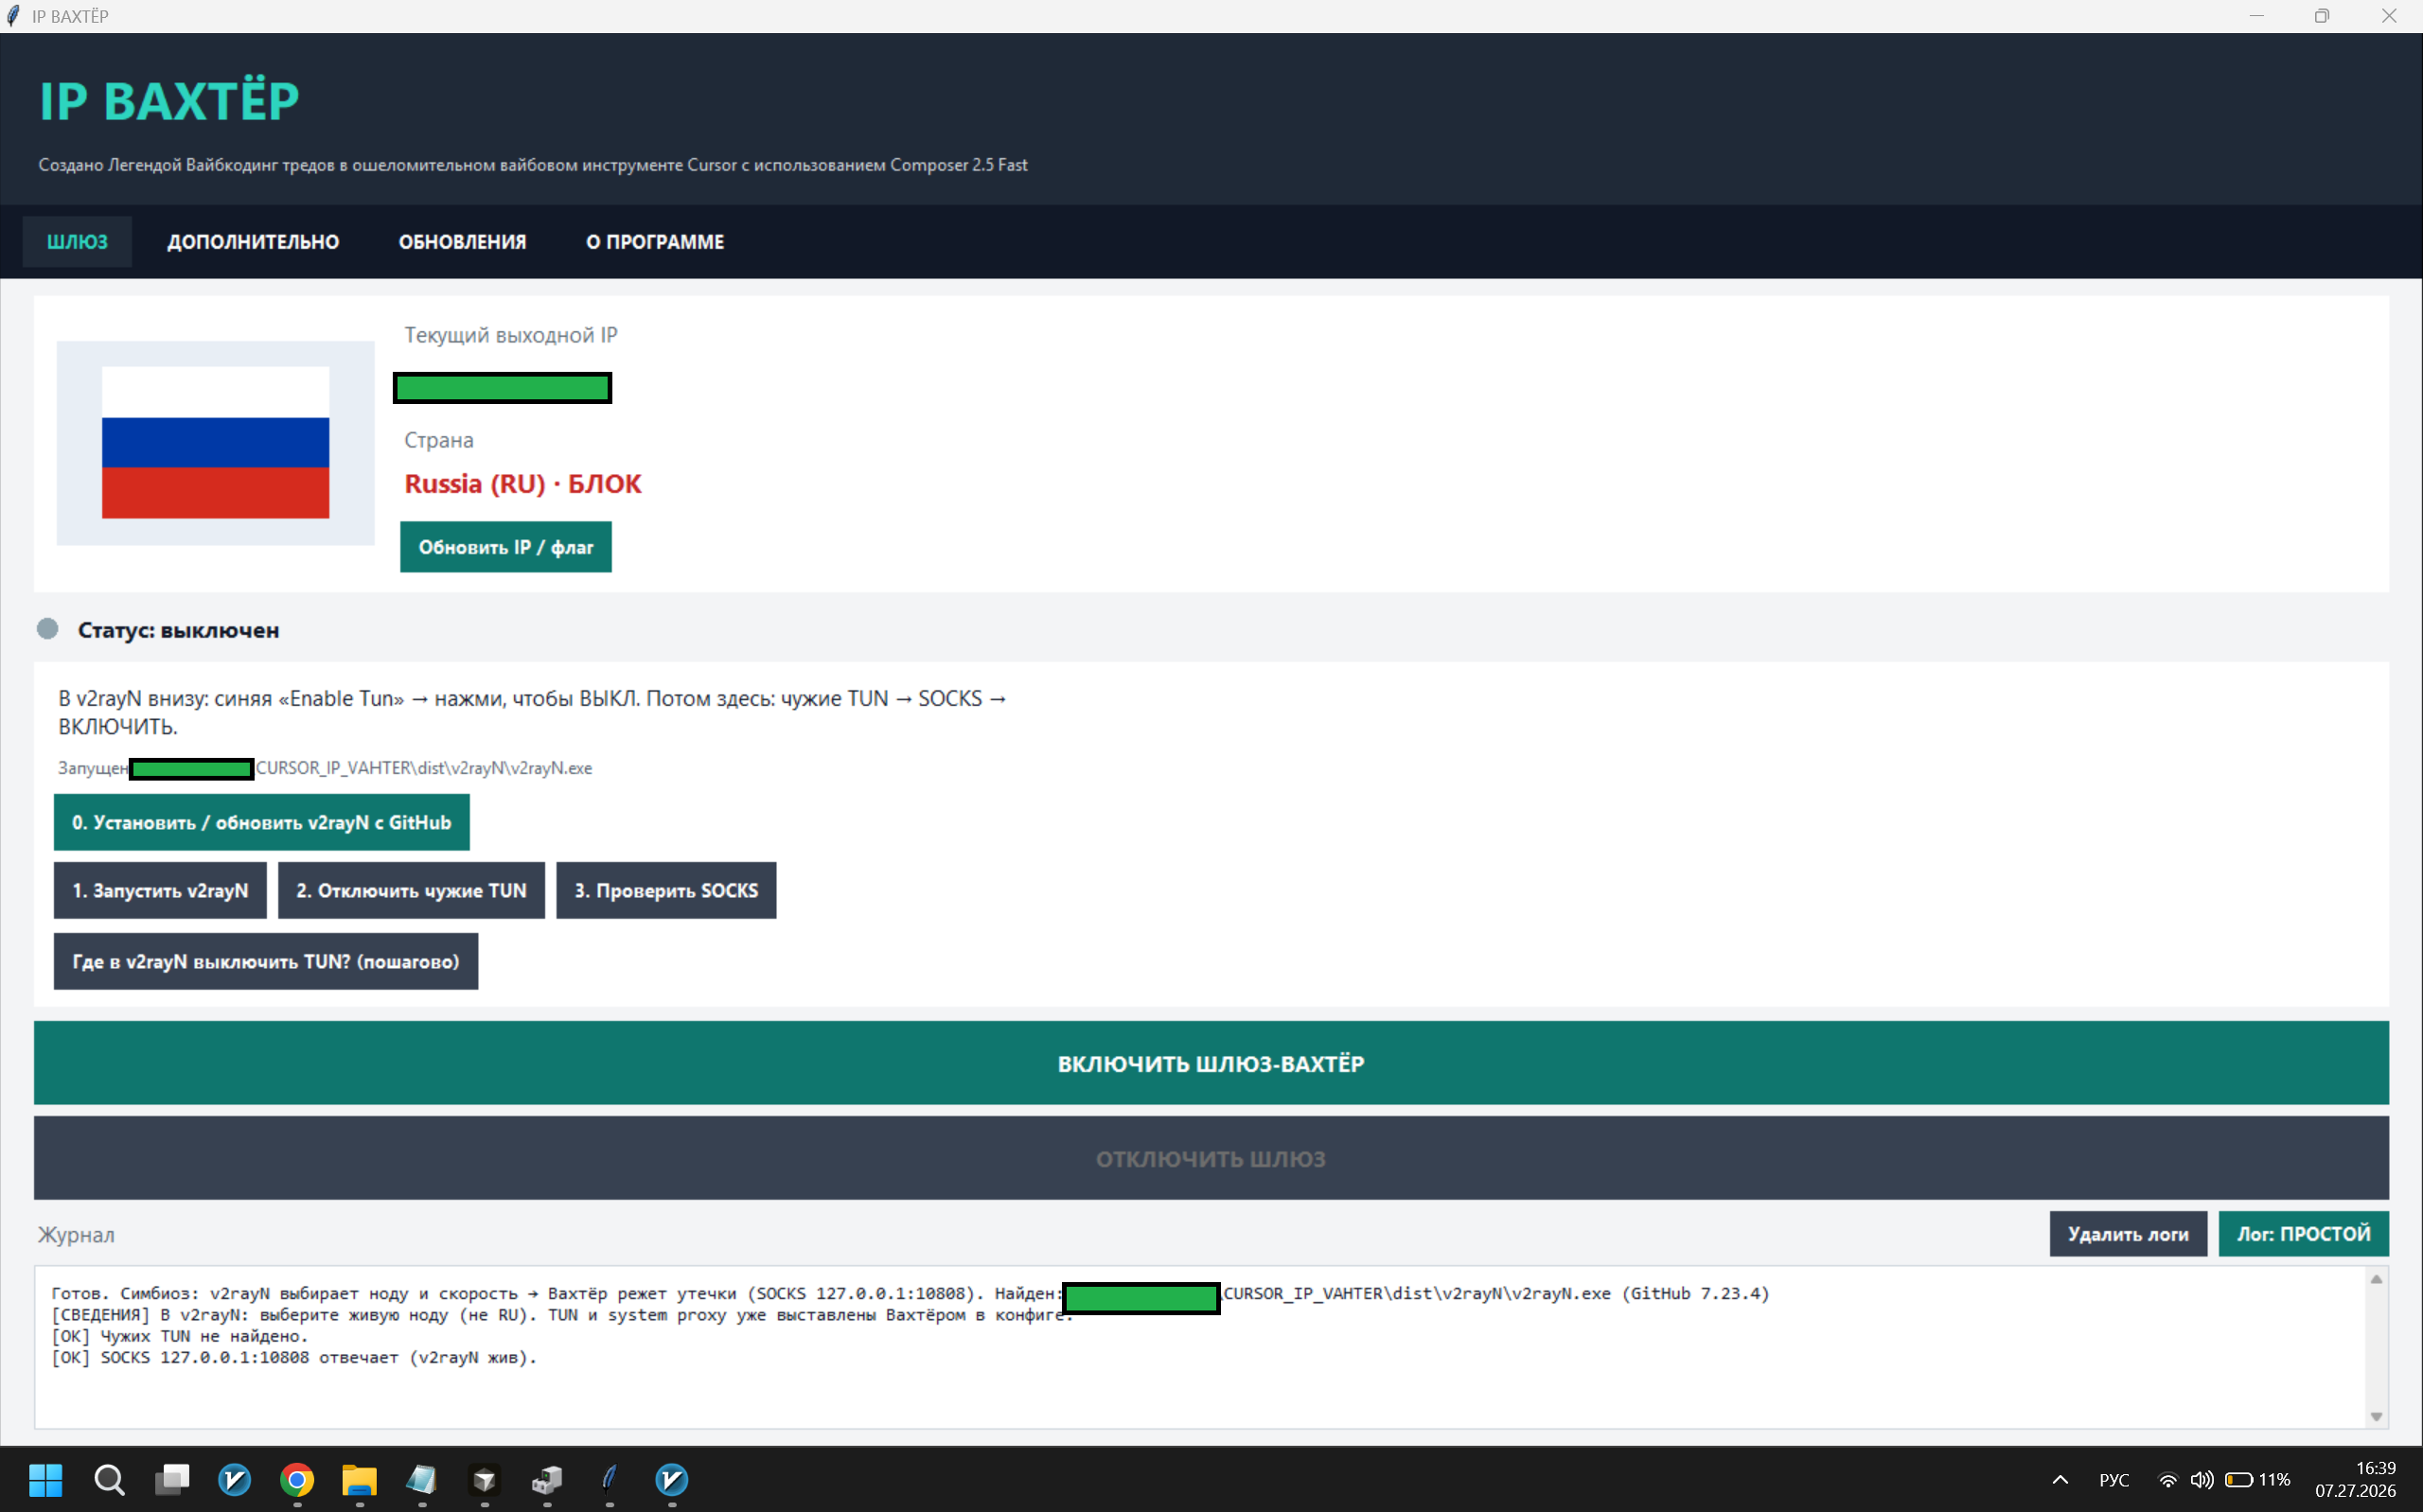
>>1661666 Всё, сделано. Но тут императивно закрыты все лазейки чтобы педерастический клод код не собирал триггеры, даже в рунет все пообрезал. Работаем чисто локально с клодкодом, без заглядывания даже на российские хостинги для работы. Это можно и потом сделать курсором или ручками. Меня всё устраивает, да и лень делать то что не нужно, потом когда нибудь, может быть допилю, наверное.
>Продукт заточен под: нельзя даже случайно сходить в запрещённую геозону destination. Цена: нельзя легально «чуть-чуть» на RU‑хостинг, не ослабив модель.
>Напряжение:
>хочешь безопасный egress FR/US для всего; >и одновременно SSH/SFTP/панель на Timeweb в РФ. >Полный блок и удобная удалёнка в рунет в одной жёсткой политике не живут — нужен второй режим или дырка по списку.
>Способы решения (на будущее, в бэклоге ROADMAP) >Allowlist — явный список (timeweb.ru, IP VPS) → direct или отдельный путь до geo-reject. >Плюс: точечно. Минус: дыра в идеологии; только ручной список + лог.
>Профиль «работа» — на сессию убрать ru из блока, огромный warning, только ручное выключение. >Грубо, но понятно.
>Split по процессу — Cursor/SSH/scp мимо блока; браузер остаётся жёстким. >Удобно для кодинга; риск, если агент сам полезет на ozon.
>Два пресета в UI — «бронедверь» (как сейчас) / «лаборатория» (мягче). >Самый честный UX.
>Вне Вахтёра — для RU‑хостинга отдельная машина/VM без шлюза или ОТКЛ Вахтёра на время деплоя. >Уже работает без кода.
>Пока выбранный ответ продукта: оставить жёсткий baseline; опции 1–4 — только после явного «делайте».
Активно репортите все нерелейтед посты кнопкой на сообщениях. Этот тред только про ИИ новости, не позволим троллям загаживать тред шитпостом и бесконечным словоблудием.
🚀 Последний обзор ИИ новостей:
📢 Главные новости ИИ
GPT-5.6 Sol от OpenAI набрала 53,6 балла на экзамене Agents' Last Exam, опередив Claude Fable 5 на 13,1 балла и выполнив задачи на 61% быстрее, что подчеркивает ее превосходство в производительности над Anthropic.
Пользователь сообщил, что Claude Cowork успешно автоматизирует задачи, не связанные с написанием кода, такие как анализ контрактов и обслуживание серверов, повышая производительность, несмотря на сохраняющиеся проблемы с доверием и безопасностью.
🧠 Модели
GPT-5.6 и ChatGPT Work от OpenAI нацелены на то, чтобы превзойти Anthropic по цене, скорости и производительности
Meta Superintelligence Labs выпускает Muse Spark 1.1 по низкой цене: мультимодальная модель рассуждений для агентских задач в Meta Model API. Контекстное окно составляет 1 000 000 токенов. Она превосходит Claude Opus 4.8 в бенчмарках для агентов
OpenAI выпустила GPT-5.6 Sol, Terra и Luna, делая упор на больший объем интеллекта на каждый токен; модели оснащены «ультра»-режимом с четырьмя агентами и показывают рекордные результаты в бенчмарках для агентов, хотя Sol и уступает Claude на SWE-Bench Pro. OpenAI сообщила, что Sol автономно провела дообучение Luna — задачу, которая раньше выполнялась старшей командой, — и назвала создание автоматизированного исследователя «почти реальностью», опередив планы на годы.
Sol стала первой моделью, прошедшей игру ARC-AGI-3, и набрала 92,5% на ARC-AGI-2 при затратах, составляющих одну десятую от стоимости трехмесячной модели, что породило шутливый вопрос: «Когда уже ARC-AGI 4?»
Luna выполняет интеллектуальные задачи уровня 5.5 за 10% от её стоимости, а аналитики из Epoch подозревают, что размер Sol сопоставим с 5.5, так что весь прирост обеспечен исключительно алгоритмами.
Sol обходит DeepSWE, работая за 38% от стоимости Fable, и устанавливает рекорд индекса Coding Agent Index, расходуя вдвое меньше токенов; на CursorBench Fable сохранила за собой корону, но проиграла «по всем пунктам, которые отражаются в вашем счете».
Sol генерировала по 750 токенов в секунду в Blender, создала клон Excel за шесть дней, бросив вызов оригиналу, стала первой моделью GPT, прошедшей Pokémon FireRed, опираясь исключительно на зрение, и за неделю с первой попытки отрисовала воксельный Манхэттен.
Fable установила недосягаемый для соперников рекорд скорости на CIFAR-10, столь изобретательно обыграв правила, что авторы назвали буквоедство барьером на пути самосовершенствования.
Порог входа продолжает снижаться: PrismML умудрилась уместить рекордную 27-миллиардную модель на iPhone.
NVIDIA выпускает Audex (Nemotron-Labs-Audex-30B-A3B): единую аудио-текстовую большую языковую модель, которая сохраняет текстовый интеллект своей базовой модели.
Meta представила Muse Image и Muse Video.
OpenAI выпустила семейство GPT-5.6 (Sol, Terra, Luna), обеспечивающее повышение эффективности использования токенов в задачах программирования до 54%, что снижает затраты корпоративного ИИ.
GPT-5.6 Sol достигает на 54% более высокой эффективности использования токенов в задачах программирования.
🛠 Инструменты для разработчиков
Google AI Studio запускает бесплатные пользовательские поддомены ai.studio для развертывания приложений разработчиков
Anthropic обновляет Claude Code, добавляя изолированный браузер в приложении для взаимодействия с внешней документацией и веб-сайтами. Инструмент командной строки может нажимать на элементы и сохранять сессии браузера.
Google выпускает LiteRT.js, высокопроизводительный веб-вывод ИИ в браузере через WebAssembly и WebGPU
Claude Code и Fable 5 за несколько часов портировали ПК-игру 2003 года Command and Conquer на нативный iOS
Zhipu AI запускает ZCode, чтобы бросить вызов Claude Code и OpenAI Codex за малую часть их стоимости
IBM обновила IBMBob, добавив мультиагентные возможности, аналитику затрат на ИИ и готовые рабочие процессы модернизации, что облегчает узкие места при проверке кода в DevSecOps.
Claude Cowork продемонстрировала надежную автоматизацию рутинной работы, не связанной с кодом, что подчеркивает практическое внедрение ИИ в качестве коллеги.
n8n выпустила рабочий процесс реагирования на инциденты на базе ИИ с использованием конвейеров RAG для автоматического сбора знаний и генерации структурированных инструкций, оптимизируя работу SOC.
📦 Продукты
Александр Ван из Meta выпускает Muse Image, агентский генератор изображений, который планирует промпты с помощью Muse Spark. Релиз включает предварительный просмотр предстоящего Muse Video.
Character.AI представила интерактивные микродрамы с голосовым ИИ. Для начала стартап запускает три микродрамы: романтический сериал под названием «Последнее лето», хоррор-шоу «Ночная игра» и микродраму о выживании в духе «Голодных игр» под названием «Падение Эдема».
OpenAI закрывает свой ИИ-браузер Atlas менее чем через год после запуска, перенося функции просмотра в свое настольное приложение и расширение для Chrome, что указывает на стратегическую переориентацию.
Google будет автоматически маркировать рекламу, созданную с помощью собственных инструментов генеративного ИИ, в Поиске, Discover и YouTube, повышая прозрачность для пользователей.
📱 Приложения
ChatGPT приходит за одной из самых умных функций Chrome от Google OpenAI расширяет возможности ChatGPT за пределы своего веб-сайта, запускает новое расширение для Chrome, которое может понимать содержимое просматриваемой вами веб-страницы. Расширение позволяет пользователям задавать вопросы о странице, резюмировать статьи, объяснять сложные концепции и даже запускать более длительные задачи на базе ИИ, не покидая браузер.
📰 Инструменты
GPT-Live предлагает полнодуплексное голосовое взаимодействие для ChatGPT, позволяя вести голосовые беседы в реальном времени.
💻 Оборудование
Zhipu AI изучает возможность разработки собственных кремниевых чипов для решения проблемы нехватки оборудования на фоне растущего спроса на ее модели GLM. Недавнее еженедельное использование токенов модели GLM-5.2 этого стартапа подскочило в 27 раз
🖱 Аппаратное обеспечение
Apple подписывает соглашение с Broadcom на производство 15 миллиардов чипов в США
Китайский стартап в области искусственного интеллекта DeepSeek разрабатывает собственный чип для ИИ, сообщают источники.
🔓 Открытый исходный код
Meituan открывает исходный код LongCat-2.0 — MoE-модели с 1,6 триллиона параметров и контекстным окном в 1 миллион токенов
Китайский ИИ-стартап MiniMax планирует открыть исходный код модели с 2,7 триллиона параметров под названием M3 Pro в третьем квартале. Сообщается, что эта модель будет крупнее любой китайской ИИ-модели, представленной в настоящее время на рынке, и более чем в шесть раз превысит размер текущей M3 от MiniMax, который, по данным SCMP, составляет 428 миллиардов параметров.
🧪 Исследования
JPMorgan создает ИИ-агентов, которые превосходят портфель 60/40 в бэктестах. Результаты обнадеживают. Исследователи банка создали массив инвестиционных агентов на базе ИИ, которые переключаются между акциями и облигациями в зависимости от изменяющихся рыночных условий. В бэктестах за последние два десятилетия самая эффективная система превзошла традиционный портфель 60/40 — 60% в акциях и 40% в облигациях — на 0,7 процентных пункта в год с меньшей волатильностью, а также обошла собственную основанную на правилах модель рыночного режима JPMorgan.
Четыре наиболее цитируемых исследования рабочей среды эпохи ИИ, прочитанные параллельно, рассказывают одну историю: прирост производительности от ИИ реален, но радикально неравномерен, и он склоняется в сторону неопытных, четко ограниченных по задачам и проверяемых — а не в сторону экспертов, выполняющих сложную, знакомую работу, и не в сторону предприятий, закупающих пилотные проекты.
Claude по-прежнему недосягаема в задачах пространственного мышления, поэтому OpenAI как нельзя кстати провела аудит SWE-Bench Pro — бенчмарка, в котором безраздельно доминирует Claude, — обнаружила, что 30% его заданий некорректны, и отозвала свое одобрение.
⚙ Инфраструктура
Micron инвестирует 250 миллиардов долларов в США, производство кастомного чипа Meta стартует в сентябре, а SK Hynix оценила свои акции в рамках размещения в США в 149 долларов.
⸻⸻⸻ Правила постинга в тред ИИ новостей, учитывайте при постинге: https://rentry.org/ainews Все нерейлейтед посты репортим.
В этом треде обсуждаем генерацию охуительных историй и просто общение с большими языковыми моделями (LLM). Всё локально, большие дяди больше не нужны!
Здесь мы делимся рецептами запуска, настроек и годных промтов, расширяем сознание контекст и бугуртим с кривейшего тормозного говна.
Тред для обладателей топовых карт NVidia с кучей VRAM или мажоров с проф. картами уровня A100, или любителей подождать, если есть оперативная память. Особо терпеливые могут использовать даже подкачку и запускать модели, квантованные до 8 5 4 3 2 0,58 бит, на кофеварке с подкачкой на микроволновку.
Дополнительные ссылки: • Перевод нейронками для таверны: https://rentry.co/magic-translation • Пресеты под локальный ролплей в различных форматах: http://web.archive.org/web/20250222044730/https://huggingface.co/Virt-io/SillyTavern-Presets • Шапка почившего треда PygmalionAI с некоторой интересной информацией: https://rentry.co/2ch-pygma-thread • Последний известный колаб для обладателей отсутствия любых возможностей запустить локально: https://colab.research.google.com/drive/11U-bC6AxdmMhd3PF9vWZpLdi6LdfnBQ8?usp=sharing • Инструкции для запуска базы при помощи Docker Compose: https://rentry.co/oddx5sgq https://rentry.co/7kp5avrk • Пошаговое мышление от тредовичка для таверны: https://github.com/cierru/st-stepped-thinking • Потрогать, как работают семплеры: https://artefact2.github.io/llm-sampling/ • Выгрузка избранных тензоров, позволяет ускорить генерацию при недостатке VRAM: https://www.reddit.com/r/LocalLLaMA/comments/1ki7tg7 • Инфа по запуску на MI50, тесты производительности и прочее: https://arkprojects.space/wiki/AMD_GFX906 • Тесты tensor_parallel: https://rentry.org/8cruvnyw
Архив тредов можно найти на архиваче: https://arhivach.vc/?tags=14780%2C14985
Шапка в https://rentry.co/llama-2ch, предложения принимаются в треде.
Аноны, всем доброго вечера суток. Это мой первый тред. Мне бы хотелось узнать какая локальная модель хороша для вайб-кода на моем железе: - RTX 3060 6GB Laptop - Intel Core i5 13420H - 16 GB Ram
Тред про AI-агентов - от вайб-кодинга до персональных ассистентов, которые сидят в твоих чатах, читают заметки и автономно ломают всё вокруг. Для кодеров, которые разучились писать руками, и для гуманитариев, чей диплом филолога наконец котируется в IT. Сеньор в 2026 - это тот, кто умеет внятно объяснить машине, чего он блять хочет.
С чего начать: • Хочешь кодить с AI эффективно: Cursor или Claude Code • Хочешь кодить в VS Code без привязки к конкретному провайдеру: Kilo Code, Cline или Roo Code + OpenRouter • Хочешь кодить с AI локально: OpenCode, Qwen Code или Pi Coding Agent + из моделей аноны советуют Qwen3.6, подробности в llama-треде • Хочешь приложение без кода: Lovable или bolt.new • Хочешь автоматизировать рутину: n8n или Langflow • Хочешь персонального ассистента: OpenClaw + API корпов или локальная модель на твоей пеке
Полезные тулзы: • RTK: https://github.com/rtk-ai/rtk - CLI-прокси, сжимает вывод консольных команд перед попаданием в контекст агента • Caveman: https://github.com/juliusbrussee/caveman - скилл с набором слэш-комманд, заставляет агента отвечать кратко • ast-grep: https://github.com/ast-grep/ast-grep - структурный поиск/замена по AST, экономит токены агента при рефакторинге • Hindsight: https://github.com/vectorize-io/hindsight - долговременная память для агентов: копит факты и помнит когда что было • fff: https://github.com/dmtrKovalenko/fff - быстрый файловый поиск/греп для агентов
Локалки и прочее API: • OpenRouter: https://openrouter.ai • NVIDIA Build: https://build.nvidia.com/models - бесплатно, 40 RPM, OAI-Like API, 100+ моделей включая DeepSeek/GLM/MiniMax • OpenCode Zen: https://opencode.ai/zen - кодинг-модели, есть временно-бесплатные (DeepSeek V4 Flash, MiMo) + pay-as-you-go без наценки • llama-тред: >>1652385 (OP)
Шаблон для переката: https://rentry.co/2ch-agents Предыдущий тред: >>1653365 (OP)
>>1660239 >ак вы коупите тот факт, что программисты - ВСЁ? >Вот я вкатился в айти в 2015м, программировать начал в 2019м. >В 2023 попробовал нейросети, но через браузер. В 2026 залетел уже в эйяй-агентуру. Эта хуйня решает 99% всех задач и проблем, с которыми стаклиаюсь просто в лоб. Я коуплю тот факт что я ниасили стать программистом ВОТ ЭТИМ ФАКТОМ, что программисты ВСЁкроме промышленных, как-то программисты АСУ ТП
После установки Stable diffusion webUI forge/neo через Stability matrix появляется ошибка OOM, при установке через git clone тоже самое. Пробовал разные версии Python от 3.10.11 до самой новой. На старом компе работало с Python 3.10.11 GTX 950 i5-2500. Нынешний ПК: i7-6700k GTX 1080 (8gb) 16 Гб ОЗУ В чем может быть проблема? Пробовал разные модели, всегда ошибка
В этом треде обсуждаем генерацию охуительных историй и просто общение с большими языковыми моделями (LLM). Всё локально, большие дяди больше не нужны!
Здесь мы делимся рецептами запуска, настроек и годных промтов, расширяем сознание контекст и бугуртим с кривейшего тормозного говна.
Тред для обладателей топовых карт NVidia с кучей VRAM или мажоров с проф. картами уровня A100, или любителей подождать, если есть оперативная память. Особо терпеливые могут использовать даже подкачку и запускать модели, квантованные до 8 5 4 3 2 0,58 бит, на кофеварке с подкачкой на микроволновку.
Дополнительные ссылки: • Перевод нейронками для таверны: https://rentry.co/magic-translation • Пресеты под локальный ролплей в различных форматах: http://web.archive.org/web/20250222044730/https://huggingface.co/Virt-io/SillyTavern-Presets • Шапка почившего треда PygmalionAI с некоторой интересной информацией: https://rentry.co/2ch-pygma-thread • Последний известный колаб для обладателей отсутствия любых возможностей запустить локально: https://colab.research.google.com/drive/11U-bC6AxdmMhd3PF9vWZpLdi6LdfnBQ8?usp=sharing • Инструкции для запуска базы при помощи Docker Compose: https://rentry.co/oddx5sgq https://rentry.co/7kp5avrk • Пошаговое мышление от тредовичка для таверны: https://github.com/cierru/st-stepped-thinking • Потрогать, как работают семплеры: https://artefact2.github.io/llm-sampling/ • Выгрузка избранных тензоров, позволяет ускорить генерацию при недостатке VRAM: https://www.reddit.com/r/LocalLLaMA/comments/1ki7tg7 • Инфа по запуску на MI50, тесты производительности и прочее: https://arkprojects.space/wiki/AMD_GFX906 • Тесты tensor_parallel: https://rentry.org/8cruvnyw
Архив тредов можно найти на архиваче: https://arhivach.vc/?tags=14780%2C14985
Шапка в https://rentry.co/llama-2ch, предложения принимаются в треде.
>>1660015 Годнота, в Chrome поставилась без вопросов, оллам с лмстудиями тоже не понадобилось, подхватила урл из обычной llama.cpp, переводит страницы по кускам, правда долго хз почему, этот же текст просто в веб интерфейсе квенчика быстрее перевести в 10 раз, может всю страницу по нескольку раз засылает вместо абзацев.
>>1660032 --reasoning-budget 100 помог + кнопку Floating translate button в расширении включить и переводить выделенные куски только ей - так скорость сразу стала приемлемой
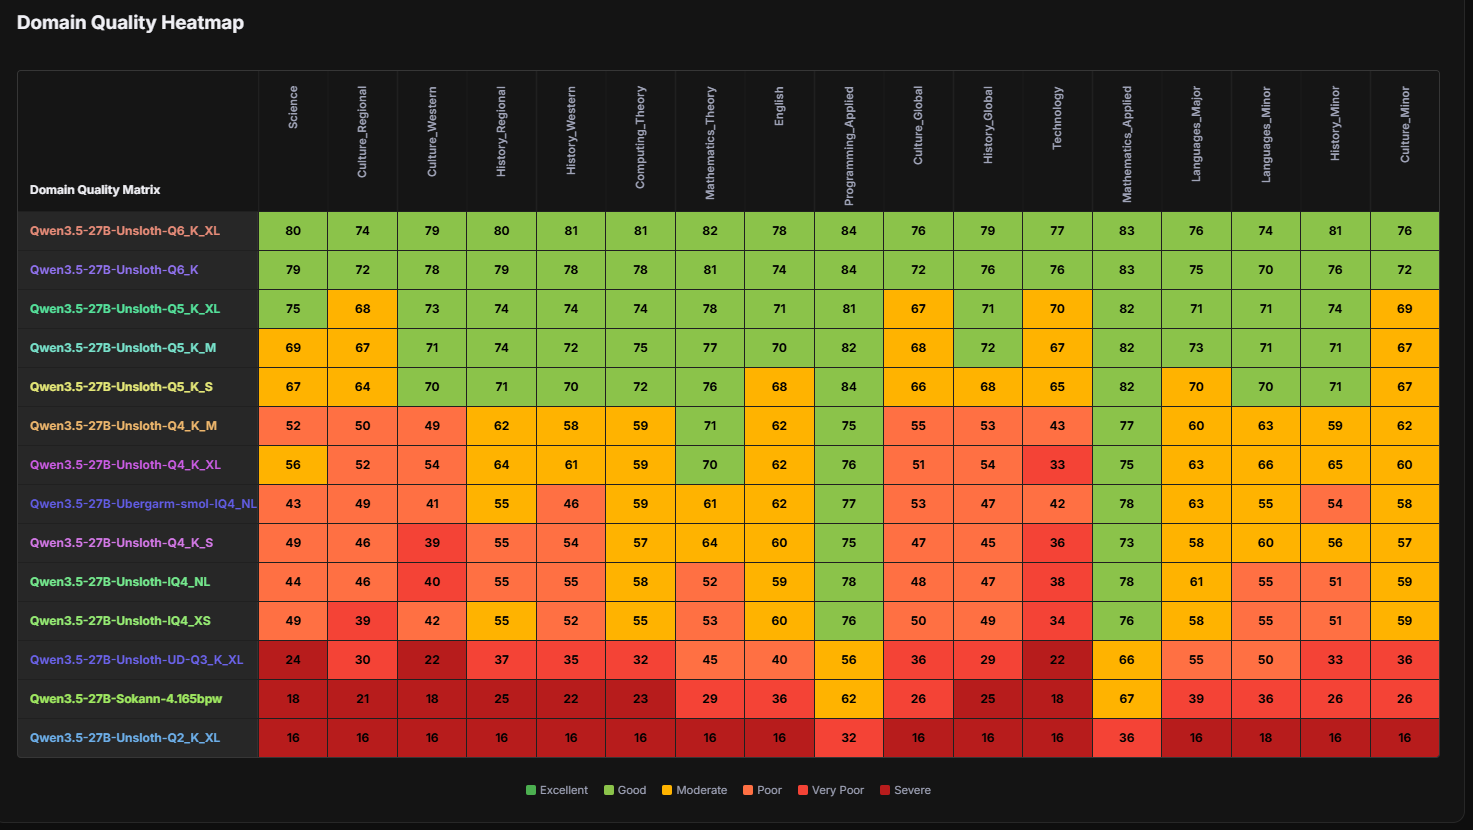
Чому mtp не работает с обычными Q5 и Q6 квантами от мразермахера и uslop llama_model_load: error loading model: invalid vector subscript
Но при этом работает с тем же услоповским QAT gemma-4-26B-A4B-it-qat-UD-Q4_K_XL.gguf и работает с gemma-4-26B-A4B-it-abliterix-v6.IQ4_XS.gguf, который вообще левый без QAT с аблитерацией Это какой-то заговор?
AI Chatbot General № 832 /aicg/
Аноним21/07/26 Втр 10:19:43№1656757Ответ